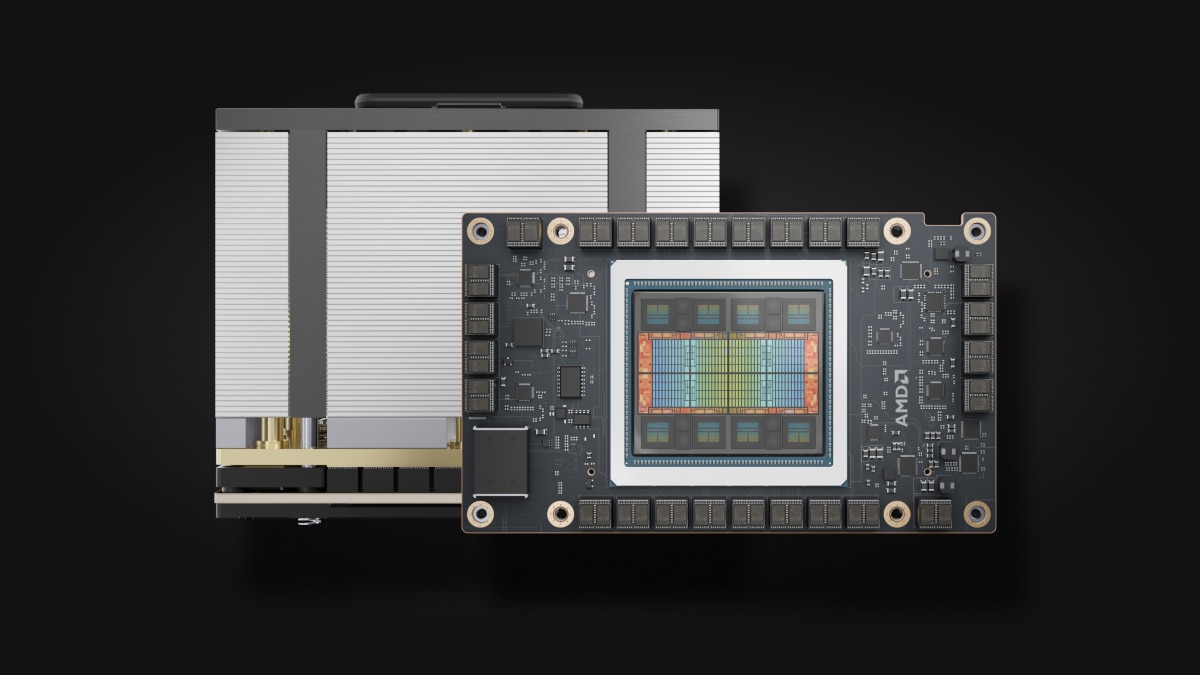
MI300A
概述OVERVIEW
MI300A是 AMD Instinct 系的 APU(Accelerated Processing Unit)加速处理器——业界首个数据中心级 CPU+GPU 融合芯片:在同一封装内集成 AMD 24 核 Zen4 CPU 与 CDNA3 架构 GPU,通过芯片内 Infinity Fabric 一致性互连,共享 128GB HBM3 统一显存(AMD 官方规格快照口径[1])。
它是 El Capitan 超算的核心——全球 Top500 榜首超算(1.742 EF)使用 MI300A 驱动(TOP500 口径[3]);ISC 2024 宣布全球 9 台新超算采用 GH200/GH200 NH2 之后,MI300A 系的 JUPITER 等欧洲旗舰超算相继上线。MI300A 的独特卖点是 FP64 Matrix 122.6 TFLOPS(对照 MI300X 的 163.4 但 A 版 CPU 核心补偿了通用计算能力)——HPC 与 AI 融合负载的 AMD 答卷。
2026 年的现货市场,MI300A 以 DGX/ODM 整机形态流通(El Capitan 类超算的配套采购为主)——单颗 APU 散卡流通极少(APU SH5 Socket 插槽形态需要专用主板)。本词条不带行情带——价格以货主实际报价为准。
适用场景FIT
萬安指数(0–100):按 HPC-AI 融合场景匹配度加权(APU 特化口径)。
沿革HISTORY
2023 年 12 月 6 日,AMD Advancing AI 大会:MI300A 与 MI300X 同场发布——业界首个数据中心级 APU,El Capitan 超算同步官宣(AMD 发布口径[1])。
2024 年 6 月,El Capitan 上线:全球首台 ExaFLOPS 级超算由 MI300A 驱动——ISC 2024 宣布全球 9 台新超算采用 GH200/MI300A 系(ISC 口径[3])。
2024 年 11 月,TOP500 榜首:El Capitan 以 1.742 EF 登顶 Top500 第 64 期——MI300A 的超算战绩达到巅峰(TOP500 口径[3])。
2025-2026 年,El Capitan 连庄后让位:TOP500 67 期(2026-06)被中国 LineShine(2.198 EF)超越退 #2,HPL-MxP 仍 #1(TOP500 口径[3])——MI300A 的科学计算遗产持续。跨境流通政策仍在演进,本库表述为公开报道口径、不构成法律意见。
技术规格SPECIFICATIONS
| 项目 | 规格(AMD Instinct MI300A · 官方口径) |
|---|---|
| APU 构成 | AMD Zen4 CPU(24 核 @ 3.7GHz)+ CDNA3 GPU(228 CU · 912 Matrix Core) |
| GPU 架构 / 制程 | CDNA3 · TSMC 5nm | 6nm FinFET · 146 亿晶体管 |
| 统一显存 | 128GB HBM3 · 8192-bit · 5.3TB/s(CPU+GPU 共享) |
| FP8 | 1.96 PFLOPs(稠密) |
| FP16 / BF16 | 980.6 TFLOPs |
| FP64 Matrix / FP64 | 122.6 / 61.3 TFLOPS |
| INT8 | 1.96 POPs |
| Infinity Fabric | 8 链路 · 128GB/s |
| 形态 | APU SH5 Socket(CPU 插槽形态装主板) |
| 功耗 | 550W TDP | 760W Peak |
| 散热 | Passive & Active |
| 发布 | 2023-12-06(Advancing AI 口径) |
规格以 AMD 官方快照为准(2026-10 口径[1],C7 侦察兵交叉核验);显存 128GB 为 CPU+GPU 共享统一显存。
MI300 家族三型号对照MI300 FAMILY
| 项目 | MI300A(APU) | MI300X(纯 GPU) | MI325X(升级版) |
|---|---|---|---|
| CPU | 24 核 Zen4 | 无 | 无 |
| GPU CU | 228 | 304 | 256 |
| 显存 | 128GB HBM3 | 192GB HBM3 | 256GB HBM3E |
| FP8 | 1.96 PF | 2.61 PF | 2.61 PF |
| FP64 Matrix | 122.6 TF | 163.4 TF | 163.4 TF |
| 功耗 | 550W | 750W | 1000W |
| 选型一句话 | HPC 超算 | AI 推理/训练 | 显存优先升级 |
三代对照为各自官方快照口径(MI300X/MI325X 详见各自词条)。
家族成员FAMILY
Instinct MI300 家族按 APU/纯 GPU 分档;MI300A 是 APU 版:
散热与部署COOLING
MI300A 的形态是 APU SH5 Socket(CPU 插槽形态装主板)——与 MI300X 的 OAM 模组形态完全不同:MI300A 像一颗超大 CPU 插在主板上,需要主板上的散热方案(被动散热片+风道或液冷冷板)。El Capitan 超算的 MI300A 使用液冷冷板直触。
部署视角:MI300A 通常随 DGX/ODM 整机方案交付——不是「买一颗卡插进去」而是「买一台 Superchip 集成的服务器」。二级市场的 MI300A 流通以超算退役整系统或OEM 项目余量为主——单颗流通极罕见。
模型适配MODEL FIT
| 模型 / 场景 | 显存需求 | MI300A 部署口径 | 萬安指数 |
|---|---|---|---|
| 科学计算 / HPC | 场景相关 | FP64 Matrix 122.6 TFLOPS + 128GB 统一显存——HPC 旗舰定位 | 93 |
| AI 推理(FP8) | 按模型大小 | FP8 1.96 PF 可用但低于 MI300X 的 2.61 PF | 82 |
| 数据密集型负载 | — | 128GB 统一显存被 CPU/GPU 共享——数据密集型负载的独特优势 | 88 |
| 纯 AI 训练 | — | FP8 算力低于 MI300X——纯 AI 训练选 MI300X 更优 | 60 |
图集GALLERY
软件与生态ECOSYSTEM
| 项目 | 要求 / 现状 |
|---|---|
| 软件栈 | ROCm 6.x(CDNA3 支持矩阵以官方文档为准) |
| HPC 软件 | MPI / HPC-X / ROCm 数学库——超算生态成熟(El Capitan 战绩支撑) |
| AI 框架 | PyTorch ROCm 版 / vLLM / SGLang——可用 |
| 虚拟化 | SR-IOV 支持(官方规格快照口径[1]) |
采购与验收PROCUREMENT
MI300A 采购的验收要点(三项):
验收速查QUICK CHECK
MI300A 四步速查:
运输与交付LOGISTICS
术语卡GLOSSARY
APU(Accelerated Processing Unit)
AMD 的 CPU+GPU 融合芯片品牌:MI300A 是业界首个数据中心级 APU——在同一封装内集成 24 核 Zen4 CPU 与 CDNA3 GPU——CPU 直接吃 HBM3 显存带宽(不经过 PCIe)。
Zen4 CPU 核心
AMD 第四代服务器 CPU 核心(Armv9 兼容但 x86 指令集):24 核 Zen4 @ 3.7GHz——通用计算能力与 GPU 的矩阵算力互补(CPU 做逻辑/序列化,GPU 做并行计算)。
El Capitan 超算
美国劳伦斯利弗莫尔国家实验室(LLNL)的 ExaFLOPS 级超算:MI300A 驱动,2024-11 TOP500 榜首(1.742 EF)——HPL-MxP 混合精度仍 #1。El Capitan 是 MI300A 的最大验证案例。
SH5 Socket
MI300A 的 CPU 插槽形态(SP5 超集):APU 以 CPU 插槽方式安装主板(非 OAM 模组)——需要专用 SH5 插槽主板,与 MI300X 的 OAM 形态完全不兼容。
HPL-MxP
混合精度 Linpack 基准:FP64+FP32+FP16/FP8 混合精度的 Linpack 变体——El Capitan 在 HPL-MxP 榜单仍 #1,反映 MI300A 在混合精度计算上的独特优势。
局限与争议LIMITS
- GPU 算力低于 MI300X:FP8 稠密 1.96 PF 对 MI300X 的 2.61 PF(约降 25%)——228 CU 对 304 CU,AI 纯计算选 MI300X 更优。
- 128GB 显存(非 192GB):MI300A 的显存容量被 CPU 占用部分削减——128GB 对 MI300X 192GB——大模型推理的显存空间缩水。
- SH5 Socket 主板门槛:APU 形态需要专用 SH5 插槽主板——不是「插任何服务器就能用」,主板选型是部署前置条件。
- El Capitan 让位中国超算:TOP500 67 期被中国 LineShine(2.198 EF)超越退 #2——MI300A 的超算霸权并非永恒(公开报道口径)。
- 跨境流通政策变量:AMD 高端 APU 同样在管制语境下(公开报道口径)——跨境采购合规以专业意见为准,本库不构成法律意见。
行情说明MARKET NOTE
MI300A 以 El Capitan 类超算配套和 DGX/ODM 整机流通为主——单颗流通极罕见。本库诚实原则:不做行情带,价格以货主实际报价为准。
在售检索:萬安算交所大厅 ›(0 佣金撮合、数据因此中立)。
价格节点大事记MILESTONES
常见问题FAQ
CPU 需求定型号:需要 CPU 侧直接参与 HPC 计算(数据预处理/向量检索/逻辑控制)或 CPU-GPU 一致性内存访问选 MI300A;纯 AI 训练/推理(GPU 独扛)选 MI300X——FP8 算力更高显存更大。
APU 保留了 Zen4 CPU 的全精度浮点管线(24 核 × AVX-512)+ CDNA3 GPU 的 FP64 Matrix——CPU+GPU 双管线叠加的 FP64 总吞吐。HPC 超算选 MI300A 的核心原因。
GPU 侧走 ROCm/HIP——CUDA 代码需要 hipify 移植(同 ROCm 词条迁移框架)。但 CPU 侧的 Zen4 核心原生跑 Linux Arm 生态——数据处理和逻辑控制不需要移植。
MI300A 驱动 El Capitan 登顶 TOP500 全球第一(1.742 EF)——这是 AMD 数据中心 APU 的最大验证案例,证明 MI300A 在超大规模科学计算中的可靠性——但 AI 训练场景的验证数据尚不及 MI300X 丰富。
不能:MI300A 是 SH5 Socket 插槽形态(装主板),不是独立插卡——以 DGX/ODM 整机方案或超算退役整系统流通为主。单颗流通极罕见。
相关词条SEE ALSO
机型对比与选型COMPARE
参考资料REFERENCES
- AMD 官网 — Instinct MI300A 产品页(官方规格表,C7 实抓快照 2026-10) https://www.amd.com/en/products/accelerators/instinct/mi300/…
- AMD Datasheet — MI300A Series Datasheet PDF(官方全表) https://www.amd.com/
- TOP500 — 2024-11 榜单:El Capitan 登顶全球第一(MI300A 驱动) https://www.top500.org/lists/top500/2024/11/
- TOP500 — 2025-06 榜单:JUPITER Booster 793.4 PFlop/s 列全球第 4 https://www.top500.org/lists/top500/2025/06/highs/
- ServeTheHome — MI300A 实测报道(第三方交叉) https://www.servethehome.com/
- 在售检索 — 萬安算交所(0 佣金撮合;MI300A 暂无行情快照,价格以货主报价为准) https://www.aixx.vip/hall.html?model=MI300A