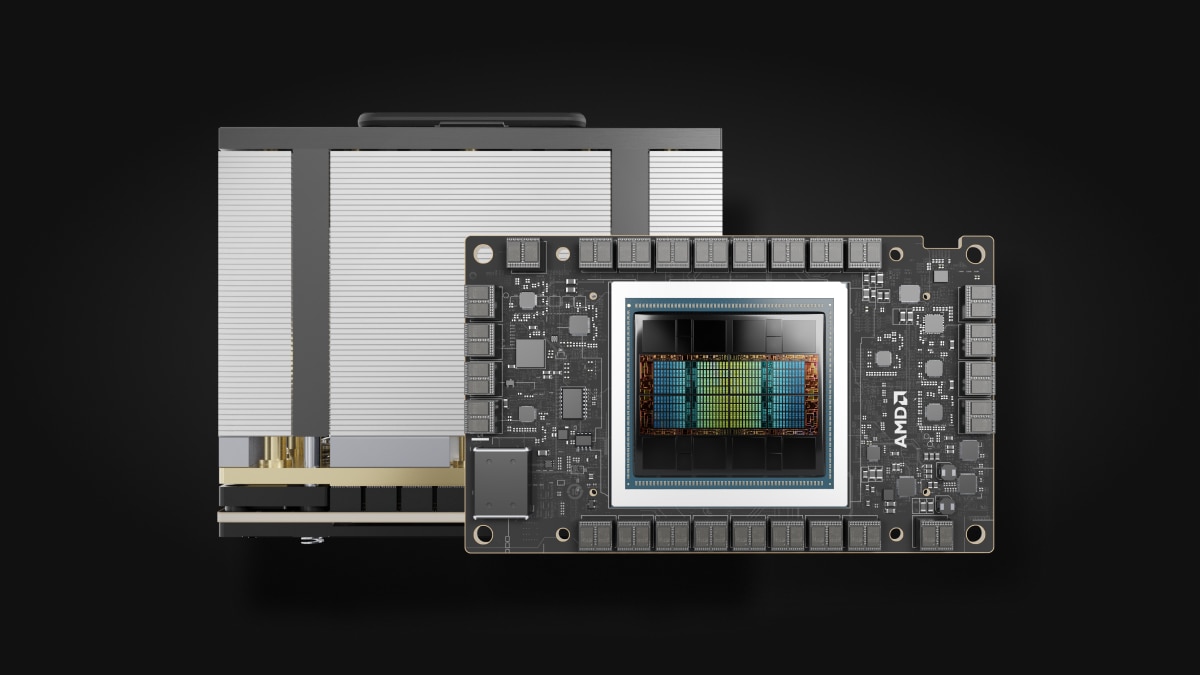
MI300X
概述OVERVIEW
MI300X(全称 AMD Instinct MI300X Accelerator,属「CDNA 3」系列)是 AMD 于 2023 年 12 月 6 日在「Advancing AI」大会上宣布发售(GA)的数据中心 GPU:单卡 192GB HBM3 与 5.3TB/s 带宽是 AMD 官方「best-in-class」口径[2],也是 2023 年时点业界最大的单卡 HBM 容量;FP8 峰值 2.61 PFLOPs、全芯片 ECC、1530 亿晶体管(TSMC 5nm+6nm 混合制程,304 计算单元 + 1216 矩阵核心,官方规格页口径[1])。
它是 CUDA 主导的数据中心市场里 AMD 第一次真正意义上的旗舰级挑战者:发布同场 AMD 就拿到了 Microsoft Azure、Meta、Oracle、Lenovo 等一排生态背书[3];同家族的 MI300A(CPU+GPU 融合 APU 版)更在 2024 年 11 月把 El Capitan 顶上了 TOP500 全球第一超算[5]——MI300 家族是 AMD 数据中心 GPU 历史上存在感最强的一代。
2026 年的现货市场,MI300X 的角色是大显存现货的 AMD 系代表:接棒的 MI325X 已于 2024 年 10 月发布(256GB HBM3E、6TB/s[6]),MI300X 从新品转入存量与现货流通。选型的核心权衡就一条:ROCm 开放软件栈(PyTorch/vLLM 等主流开源框架可用)对 CUDA 存量产线的迁移成本。本词条不带行情带——MI300X 暂无统一行情快照,价格以货主实际报价为准。
适用场景FIT
萬安指数(0–100):本库按公开规格加权估算——显存 40% + 互联 30% + 生态 30%,按场景调权。90+ 旗舰级 · 75+ 优秀 · 60+ 可用 · 60 以下不适用。方法透明可复核,不构成性能承诺。
沿革HISTORY
2023 年 12 月 6 日,AMD 在「Advancing AI」大会宣布 MI300 系列发售(GA):MI300X 以 192GB HBM3 / 5.3TB/s 的「best-in-class」显存口径亮相,同日发布的还有全球首款数据中心 APU MI300A,以及 Microsoft Azure、Meta、Oracle、Lenovo 等生态伙伴的采用背书[2][3]。
2024 年,生态落地铺开:Azure 推出 MI300X 虚拟机系列、Meta 与 Oracle 相继披露基于 MI300X 的推理部署(AMD 生态稿口径[3]),Dell、Supermicro、联想等整机厂的 8 卡 OAM 整机(如 Dell PowerEdge XE9680)成为主流交付形态(各家官方产品线口径)。2024 年 11 月,驱动 El Capitan 的 MI300A 把这台超算顶上 TOP500 全球第一[5]——MI300 家族的高光时刻。
2024 年 10 月 10 日,接棒机型 MI325X 发布:显存升至 256GB HBM3E、带宽 6TB/s,核心算力规格与 MI300X 同档(FP8 同为 2.61 PFLOPs[6])——MI300X 自此从新品转入存量与现货流通阶段。
2026 年,现货市场定位成型:MI300X 以「单卡 192GB 大显存 + 开放软件栈」的差异化身份在二手与现货渠道流通,与 NVIDIA 阵营的 H200(141GB HBM3e)形成正面竞争。围绕高端数据中心的跨境流通政策仍在演进,采购时以主管部门政策与专业意见为准(公开报道口径,不构成法律意见)。
技术规格SPECIFICATIONS
| 项目 | 规格(AMD Instinct MI300X · 官方口径) |
|---|---|
| GPU 架构 | AMD CDNA 3(芯粒设计,TSMC 5nm + 6nm FinFET 混合制程) |
| 计算单元 / 矩阵核心 | 304 CU / 1216 矩阵核心 · 19,456 流处理器 |
| 峰值引擎时钟 | 2100 MHz |
| 单卡显存 | 192GB HBM3 · 全芯片 ECC |
| 显存带宽 | 5.3TB/s(8192-bit 位宽 · 显存时钟 5.2GHz) |
| FP8(E5M2/E4M3) | 2.61 PFLOPs |
| FP16 | 1.3 PFLOPs |
| TF32 Matrix / FP32 | 653.7 TFLOPS / 163.4 TFLOPS |
| FP64 Matrix / FP64 | 163.4 TFLOPS / 81.7 TFLOPS |
| INT8 | 2.6 POPs |
| 末级缓存(LLC) | 256MB |
| 卡间互联 | Infinity Fabric 8 链路 · 单链路 128GB/s |
| 主机接口 | PCIe Gen5 x16 |
| 形态 / 散热 | OAM 模组 · 被动散热(Passive OAM) |
| 供电 / 功耗 | 54V UBB 基板供电 · 板级功耗峰值(TBP)750W |
| 虚拟化 | SR-IOV 支持(单卡切多虚拟机) |
| 晶体管数 | 1530 亿 |
| 上一代 / 接棒 | MI210(CDNA2 · 64GB)/ MI325X(256GB HBM3E) |
规格以 AMD 官方产品页为准(2026-10 实抓快照[1],与本库薄卡 spec_reference 逐条对账一致);「Peak」均为官方标称口径。
代际对照 · AMD 三代 + NVIDIA 参照GENERATIONS
| 项目 | MI210 | MI300X | MI325X | H200(参照) |
|---|---|---|---|---|
| 单卡显存 | 64GB HBM2e | 192GB HBM3 | 256GB HBM3E | 141GB HBM3e |
| 显存带宽 | 1.6TB/s | 5.3TB/s | 6TB/s | 4.8TB/s |
| 标志精度 | FP16/BF16 | FP8 | FP8 | FP8(Transformer Engine) |
| 卡间互联 | IF 3 链路 · 100GB/s | IF 8 链路 · 128GB/s | IF 8 链路 · 128GB/s | NVLink 4 · 900GB/s |
| 选型一句话 | 上代余量 · 特定 HPC | 大显存现货 · 开放栈 | 接棒新购 · 显存再升 33% | CUDA 生态 · 大显存主力 |
MI210/MI325X 列为本库薄卡同款官方快照口径[1][6];H200 列详见 H200 词条。
家族成员FAMILY
MI300 家族按「纯 GPU / APU / 显存世代」分三支;MI300X 是纯 GPU 旗舰,2026 年现货流通的主力成员如下:
散热与部署COOLING
MI300X 的部署形态在官方规格表里只有一种:OAM 模组 + 被动散热 + 54V UBB 基板供电[1]。这意味着它从不以「一张卡」的形态出现——8 张 MI300X 焊在 OAM 基板上组成一台整机(UBB 母排集中供 54V),GPU 合计满载约 6kW(8×750W 推算口径,不含 CPU 与风扇),机房的电力、母排与风道必须按整柜规划。对采购方的含义:买 MI300X 就是买整机方案,普通 PCIe 风冷工位插不进去,老机房改造前先算电力账。
SR-IOV 是部署上的实用牌:单卡可切多个虚拟机实例(官方规格页口径[1]),配合容器编排做多租户推理池——192GB 的大显存切成几份给不同业务组,利用率比整机独占高不少。
模型适配MODEL FIT
| 模型 / 场景 | 显存需求(FP16 估算) | MI300X 部署(8 卡 1536GB) | 萬安指数 |
|---|---|---|---|
| DeepSeek R1 满血(671B) | FP16 约 1.3TB / FP8 约 690GB | 8 卡装得下——FP8 约 690GB 对 1536GB 余量充足,FP16 临界可跑;「单节点跑满血 R1」是 MI300X 现货市场最响的招牌 | 82 |
| 70B 级开源模型 | FP16 约 140GB | 单卡直装——192GB 装 70B FP16 还有余量给 KV cache;对比 80GB 级卡必须双卡起步,通信开销直接省掉 | 90 |
| 7B-14B 级 | FP16 约 14-28GB | 单卡轻松,靠 SR-IOV 切片或多卡堆并发做批量产线 | 88 |
| 科学计算 / FP64 仿真 | 视网格规模 | FP64 Matrix 163.4 TFLOPS + 192GB 显存,「算得动且装得下」的组合 | 75 |
显存按 FP16 权重 ≈ 参数量 × 2 字节估算(推算口径,未含 KV cache 与激活余量);R1 满血数值与本库 A100/H200 词条同口径。ROCm 侧推理栈以 vLLM/SGLang 等开源引擎为主,部署前先验证目标框架的 ROCm 版本兼容性。
图集GALLERY
实拍图随验货批次上架持续补充;AI 生成图不冒充实拍。
软件与生态ECOSYSTEM
| 项目 | 要求 / 现状 |
|---|---|
| 软件栈 | ROCm(AMD 开放软件栈)——MI300X 发布起即为主支持对象,现役 6.x 持续更新 |
| 训练框架 | PyTorch 官方 ROCm 版支持;Megatron / DeepSpeed 等有社区适配,成熟度低于 CUDA 侧 |
| 推理引擎 | vLLM / SGLang 等主流开源引擎有 ROCm 支持;TensorRT 等 NVIDIA 专有栈不可用 |
| 驱动 | amdgpu 内核驱动(随 ROCm 安装);rocm-smi / amd-smi 为系统观测工具 |
| 虚拟化 | SR-IOV 官方支持[1],多租户切分方案成熟 |
| 云生态 | Microsoft Azure / Oracle Cloud 等提供 MI300X 实例(AMD 生态稿口径[3]) |
| 操作系统 | 主流 Linux 发行版(Ubuntu / RHEL 系,以 ROCm 官方支持矩阵为准) |
ROCm 生态经两年沉淀已覆盖主流开源训练与推理栈,但算子覆盖与调优人力仍少于 CUDA——迁移前先跑目标模型的基准验证。软件栈版本随时间演进,以 AMD 官方发布为准。
采购与验货PROCUREMENT
MI300X 采购的验货要点(三项):
完整六项压测判例(数值为 MI300X 实锚)见本词条「如何压测」节。
如何压测BENCH TEST
六项压测口径,数值判例全部按 MI300X 实锚:开箱识别 → 单卡烤机(750W Peak,≤86℃ 零 ECC 合格)→ 全机满载 → 显存带宽(标称 5.3TB/s,≥85% 合格)→ 互联带宽(rccl-tests 总线带宽达标)→ 推理吞吐(≥公开基准 80%)。
运输与交付LOGISTICS
OEM 与变体VENDORS
MI300X 的整机生态在发布时就拿到了一排背书[3],各家 8 卡 OAM 整机是主流交付形态:
| 整机厂 | 代表形态 | 差异点 | 2026 年现状 |
|---|---|---|---|
| Dell 戴尔 | PowerEdge XE9680(8 卡 OAM) | 全球一线服务网络,AI 整机走量主力 | 现货与存量流通主力之一 |
| Supermicro 超微 | 8 卡 OAM 整机(风冷 / 液冷) | 形态齐全,交付节奏快 | 现货流通 |
| Lenovo 联想 | 8 卡 OAM 整机 | 企业级服务网络 | 项目制流通 |
| Microsoft Azure | 云实例(ND MI300X 系) | 不上门——云侧租用替代自购的参照系 | 在营(AMD 生态稿口径) |
整机厂信息来自各家官方发布与 AMD 生态稿[3];具体型号与配置以厂商官方产品线为准,云实例形态供租用/自购比价参照。
术语卡GLOSSARY
HBM3 显存
第三代高带宽显存。MI300X 单卡 192GB HBM3、带宽 5.3TB/s、全芯片 ECC——2023 年发布时是业界最大单卡 HBM 容量(AMD「best-in-class」口径);上代 MI210 为 64GB HBM2e,接棒的 MI325X 为 256GB HBM3E。
CDNA 3 与芯粒设计
AMD 数据中心 GPU 第三代架构。MI300X 用芯粒(chiplet)设计把多个计算芯粒(XCD)与 I/O 芯粒(IOD)封装在一起,TSMC 5nm+6nm 混合制程、1530 亿晶体管、304 计算单元 + 1216 矩阵核心——芯粒是 AMD 在先进制程成本与良率上的招牌打法。
Infinity Fabric
AMD 的卡间高速互联:MI300X 提供 8 条链路、单链路 128GB/s,多卡经 OAM 基板组网;软件侧对应的集合通信库是 rccl(NCCL 的 ROCm 移植)。压测时 rccl-tests 的总线带宽是多卡系统的必测项。
OAM 与 54V UBB
OAM(OCP Accelerator Module)是开放计算标准的加速卡模组规范;UBB(Universal Baseboard)是 8 卡基板,以 54V 母排集中供电。MI300X 750W Peak 的功耗决定了它必须「整机交付」——基板供电与机柜散热是部署的硬前提。
SR-IOV
单根 I/O 虚拟化:把一张物理卡切给多个虚拟机直接使用。MI300X 官方支持 SR-IOV(官方规格页口径),配合 192GB 大显存做多租户推理池是它的实用玩法——采购验货时切分功能可用性应列入测试项。
ROCm
AMD 的开放计算软件栈(ROCm = Radeon Open Compute):驱动、编译器、数学库与 HIP 工具链的集合,PyTorch/vLLM 等主流开源框架有 ROCm 版。与 CUDA 的生态差距是 MI300X 选型的核心变量——开源栈能覆盖的产线迁移顺滑,深度绑定 NVIDIA 专有组件(如 TensorRT)的产线迁移成本高。
局限与争议LIMITS
- 生态差距是第一变量:ROCm 对 CUDA 的差距不在「能不能跑」(主流开源框架都能跑),而在算子覆盖、调优人力与排障资料的厚度——迁移成本要按人月算,不是按天数算(本库验货经验与公开评测共识口径)。深度绑定 CUDA 专有组件的产线,不建议为价差硬迁。
- 互联规格与 NVIDIA 旗舰有代差:Infinity Fabric 单链路 128GB/s、8 链路组网,多卡扩展性依赖基板拓扑;NVIDIA 阵营 NVLink 4 已是 900GB/s 单卡口径(H200)——大模型跨卡张量并行的通信效率,是 MI300X 集群方案要认真压测的项。
- 750W 功耗与整机门槛:被动散热 + 54V UBB 基板供电,8 卡整机 GPU 合计满载约 6kW(推算口径)——没有整机方案与机房改造预算,「低价买模组」不是可执行选项。
- 接棒机型的残值压力:MI325X 已于 2024-10 发布(256GB HBM3E、6TB/s,算力同档[6]),MI400 系列在 AMD 公开路线图上——MI300X 的现货价差要对照接棒机型走势看,残值曲线偏陡。
- 跨境流通政策变量:高端数据中心 GPU 的对华出口管制政策持续演进,MI300 系列的跨境合规状态随政策变动(公开报道口径)——本库仅作政策演进提醒,具体判定以主管部门政策与专业意见为准,不构成法律意见。
行情说明MARKET NOTE
MI300X 现货以整机方案与渠道库存为主,配置(整机/模组)、成色、保修与渠道条件让价格离散度大——暂无可复核的统一行情快照,本库诚实原则:不做行情带,价格以货主实际报价为准。
在售检索:萬安算交所大厅 ›(0 佣金撮合、不参与交易,不掌握亦不推测成交价,数据因此中立)。行情快照积累充分后本节将切换为标准行情带。
价格节点大事记MILESTONES
常见问题FAQ
能(FP8 口径):R1 满血 671B 的 FP8 权重约 690GB,8 卡 MI300X 合计 1536GB 显存装得下且余量充足(FP16 约 1.3TB 为临界);推理栈用 vLLM/SGLang 的 ROCm 版。「单节点跑满血 R1」是它现货市场最响的卖点。
看软件栈:显存与带宽 MI300X 占优(192GB/5.3TB/s 对 141GB/4.8TB/s),算力同代(都主打 FP8);但 H200 背靠 CUDA 生态与 NVLink 4(900GB/s)。开源栈新产线、追大显存性价比——MI300X;深度绑定 CUDA 的存量产线、追生态省心——H200。
MI300X 无显示输出、算力形态不用于挖矿,「无矿」问法意义有限;真实风险是数据中心高负载老化与翻新。正确姿势:问机房负载史与上电时长、rocm-smi 识别与序列号验真、导出 ECC 日志、走六项压测(显存带宽与 rccl 互联是重点)。
PyTorch(官方 ROCm 版)、vLLM、SGLang 等主流开源框架都能跑;TensorRT 等 NVIDIA 专有组件不可用。建议部署前先拿目标模型在 ROCm 上跑一次基准——开源栈覆盖度两年内进步很快,但算子兼容仍要逐个验证。
正常流通是 8 卡 OAM 整机(UBB 基板 + 机柜级散热 + 54V 母排),Dell XE9680 等整机是主流形态;「散模组」脱离基板与风道无法独立使用,低价散卡要警惕来源。采购认准整机方案、核验供电散热配套与随货文件。
相关词条SEE ALSO
机型对比与选型COMPARE
参考资料REFERENCES
- AMD 官网 — Instinct MI300X 产品页(规格主档,2026-10 实抓,与本库薄卡快照对账一致) https://www.amd.com/en/products/accelerators/instinct/mi300/…
- AMD Newsroom — AMD Delivers Leadership Portfolio of Data Center AI Solutions with AMD Instinct MI300 Series(2023-12-06 发售稿) https://www.amd.com/en/newsroom/press-releases/2023-12-6-amd…
- AMD Newsroom — AMD Showcases Growing Momentum for AMD Powered AI(2023-12-06 生态稿:Azure/Meta/Oracle/Lenovo) https://www.amd.com/en/newsroom/press-releases/2023-12-6-amd…
- TechPowerUp GPU 数据库 — AMD Instinct MI300X(第二源) https://www.techpowerup.com/gpu-specs/instinct-mi300x.c4179
- TOP500 — 2024 年 11 月榜单:El Capitan 登顶全球第一(MI300A 驱动) https://www.top500.org/lists/top500/2024/11/
- AMD 官网 — Instinct MI325X 产品页(接棒世代,256GB HBM3E / 6TB/s) https://www.amd.com/en/products/accelerators/instinct/mi300/…
- 在售检索 — 萬安算交所(0 佣金撮合;MI300X 暂无行情快照,价格以货主报价为准) https://www.aixx.vip/hall.html?model=MI300X