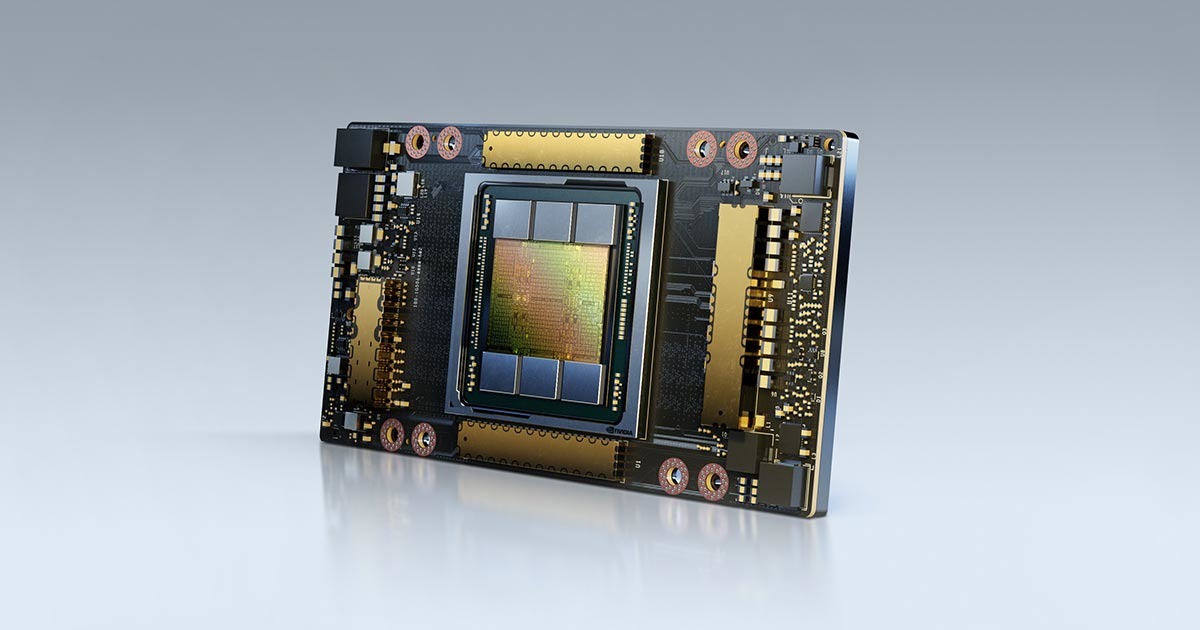
A100 80GB
概述OVERVIEW
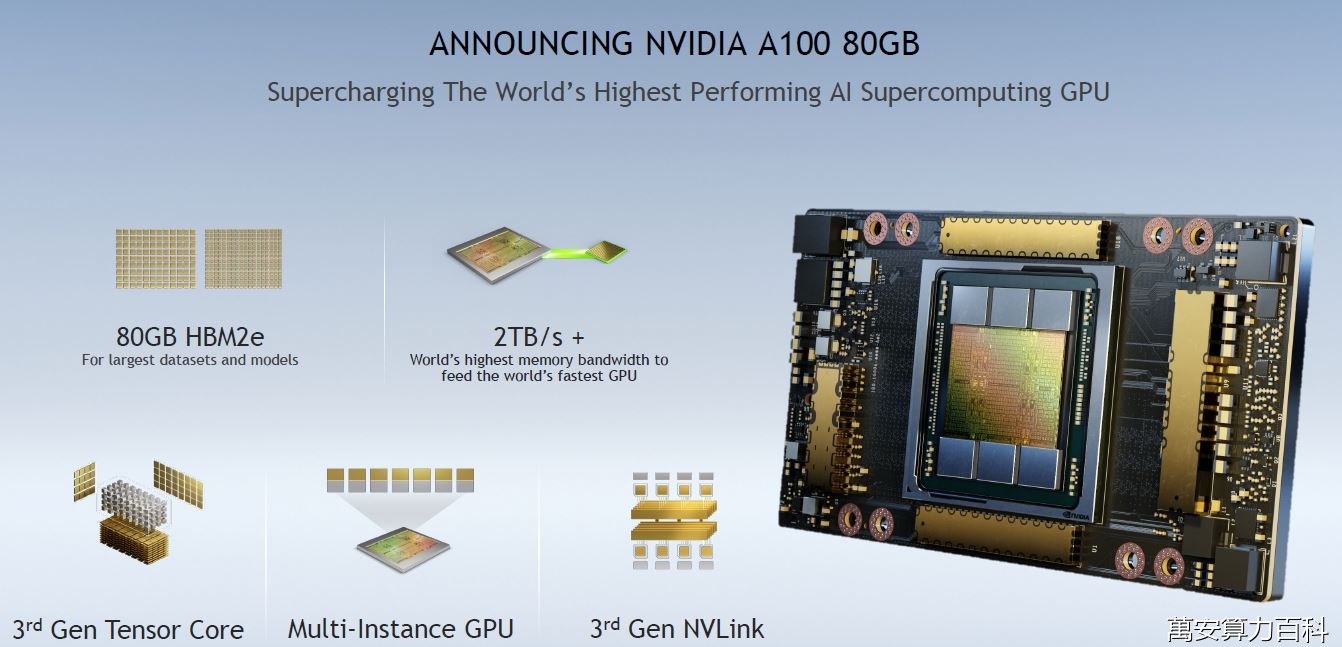
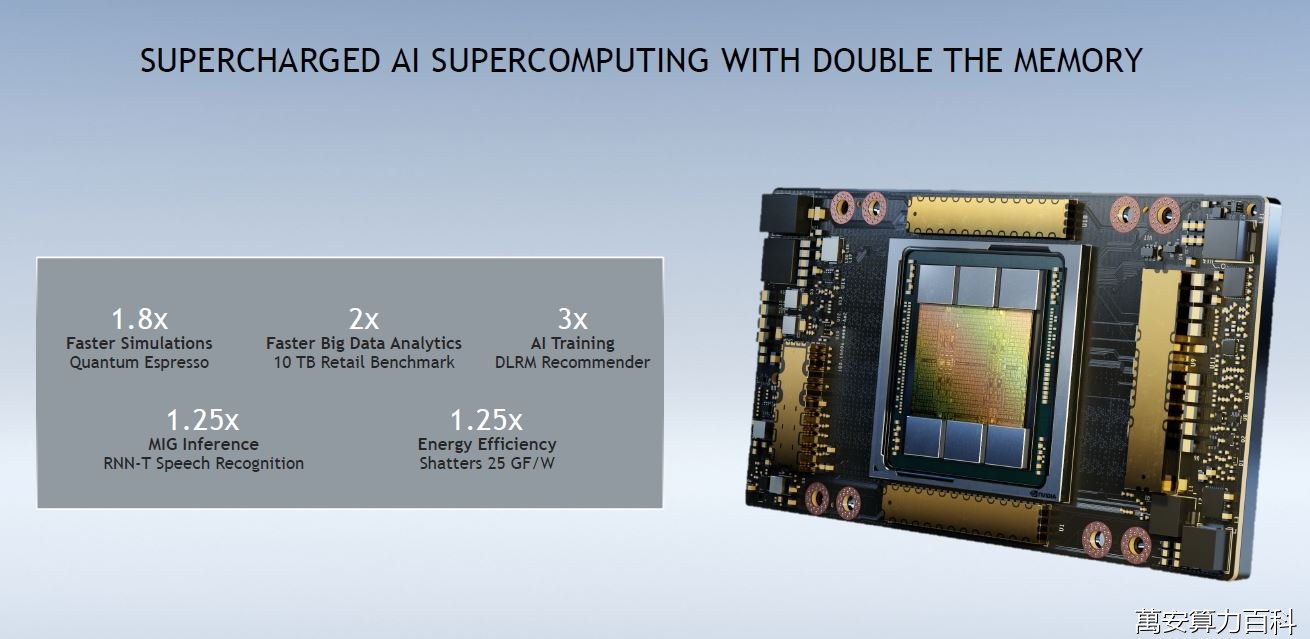
A100(全称 NVIDIA A100 Tensor Core GPU,属「Ampere」系列)是 NVIDIA 于 2020 年 5 月 14 日在 GTC 发布的数据中心 GPU:Ampere 世代开山之作,首发第三代 Tensor Core(TF32 与结构性稀疏)和 MIG 多实例切分(单卡最多切 7 个实例)[1][4];80GB 版于 2020 年 11 月 16 日公布,HBM2e 显存翻倍、带宽超 2TB/s(官方「全球最快显存带宽」口径)[2]。SXM 与 PCIe 双形态、40GB/80GB 两档容量,是本库机型词条里唯一「整机厂全家桶」级存量。
它是 H100 之前那一代的「AI 算力硬通货」:ChatGPT 引爆全球算力军备竞赛时,各家训练集群的主力正是 A100(ServeTheHome 曾专文盘点 8×A100 整机全家桶[11])。它也是 2022 年 10 月美国对华出口管制锁定的第一批机型——特供衍生 A800 与 2023-10 管制升级,构成了一条完整的政策时间线(见「沿革」与「局限与争议」)。
2026 年的现货市场,A100 的角色是存量延续:产品线已进入生命周期尾声(2024 年初渠道收到全系 EOL 通知,渠道转述口径[9]),正规渠道新卡基本无新增,流通以退役机、渠道库存与二手为主。80GB HBM2e 在推理与传统 HPC 场景仍能打,但对 H200(141GB HBM3e)与 B300(288GB HBM3e)的显存代差肉眼可见。本词条不带行情带——A100 已无统一行情,价格以货主实际报价为准。
适用场景FIT
萬安指数(0–100):本库按公开规格加权估算——显存 40% + 互联 30% + 生态 30%,按场景调权,并叠加 EOL 状态修正。90+ 旗舰级 · 75+ 优秀 · 60+ 可用 · 60 以下不适用。方法透明可复核,不构成性能承诺。
沿革HISTORY
2020 年 5 月 14 日,NVIDIA 在 GTC 发布 Ampere 架构与 A100(40GB 版首发):第三代 Tensor Core 让 TF32 与结构性稀疏首次进入数据中心 GPU,MIG 把单卡切成最多 7 个带 QoS 保障的实例;同日发布的 DGX A100 把 8 卡整机推向 AI 机房[1][4]。
2020 年 11 月 16 日,80GB 版公布:HBM2e 容量翻倍、带宽超 2TB/s,8 卡系统显存合计 640GB[2];PCIe 版随后铺开(TechPowerUp 数据库渠道记录为 2021 年 6 月[3])。此后一年多,HGX A100 8 卡整机成为全球 AI 算力扩张的标准形态。
2022 年 8-10 月,美国对华出口管制落地:A100/H100 对华出口需许可证,2022 年 10 月 13 日联邦公报正式规则生效[5][7];NVIDIA 随即推出对华特供 A800(互联带宽降档以符合阈值),成为 2022-2023 年中国大陆市场的主力流通型号(公开报道口径[7])。
2023 年 10 月管制升级,A800/H800 一并纳入许可管理(2023-10-25 联邦公报规则[6]),对华需求此后转向 H20/L20/L2 特供线(2023 年 11 月起公开报道口径[7])。A100 本体自始至终在管制清单内,从未回到对华获批清单。
2024-2026 年,产品线进入尾声:渠道于 2024 年初收到 A100 全系 EOL 通知(渠道转述口径[9]);存量机与数据中心退役机成为现货市场流通主力,围绕高端 GPU 的灰市与走私案件见于公开报道[8][10]。2025 年 12 月 H200 获批对华(公开报道口径[12])后,世代接棒进一步加速。
技术规格SPECIFICATIONS
| 项目 | 规格(A100 80GB · 官方口径,SXM / PCIe 分列处已注明) |
|---|---|
| GPU 核心 | NVIDIA Ampere GA100 |
| 单卡显存 | 80GB HBM2e(SXM 与 PCIe 同容量;另有 40GB 版) |
| 显存带宽 | 2,039GB/s(SXM)/ 1,935GB/s(PCIe) |
| FP64 / FP64 Tensor Core | 9.7 / 19.5 TFLOPS |
| FP32 | 19.5 TFLOPS |
| TF32 Tensor Core | 156 TFLOPS(稀疏 312) |
| BF16 / FP16 Tensor Core | 各 312 TFLOPS(稀疏 624) |
| INT8 Tensor Core | 624 TOPS(稀疏 1248) |
| 卡间互联 | NVLink 第三代 · 600GB/s(HGX 基板 NVSwitch 全互联;PCIe 经桥接器双卡 600GB/s) |
| 主机接口 | PCIe Gen4 · 64GB/s |
| 单卡功耗(TDP) | SXM 400W(HGX 定制散热 CTS SKU 最高 500W,官方脚注)/ PCIe 300W |
| 多实例切分 | MIG 最多 7 实例 @ 10GB(80GB 版单实例显存翻倍) |
| 主流整机形态 | HGX A100 4/8/16-GPU 基板 · DGX A100 8 卡 · 合作伙伴 1-8 卡整机 |
| 上一代 / 对位产品 | V100 / H100、A800(对华特供衍生) |
规格以 NVIDIA 官方产品页为准(2026-10 实抓)[1];「稀疏」为官方以星号标注的结构性稀疏口径,dense 减半;CTS(定制散热方案)为 HGX A100-80GB 官方脚注口径。
代际对照 · 四代同览GENERATIONS
| 项目 | A100 80GB | H100 80GB | H200 | B300 |
|---|---|---|---|---|
| 单卡显存 | 80GB HBM2e | 80GB HBM3 | 141GB HBM3e | 288GB HBM3e |
| 显存带宽 | 约 2TB/s | 3.35TB/s | 4.8TB/s | 约 8TB/s |
| 标志精度 | FP16(TF32+稀疏首发) | FP8(Transformer Engine) | FP8 | FP4 |
| 卡间互联 | NVLink 3 · 600GB/s | NVLink 4 · 900GB/s | NVLink 4 · 900GB/s | NVLink 5 · 1.8TB/s |
| 选型一句话 | 存量延续 · 二手为主 | 预算极限 · 生态最大 | 大显存 · 走量主力 | 旗舰新购 · 下一代 |
规格以 NVIDIA 官方公开资料为准[1];H100/H200/B300 列详见各自词条对照。
家族成员FAMILY
A100 家族按显存容量与封装分四支,另有对华特供衍生 A800;2026 年现货流通以 80GB 版(SXM/PCIe)与退役机为主:
散热与部署COOLING
A100 的散热形态在官方规格表里写得很直白:SXM 版 400W 被动散热,靠 HGX 基板所在机箱的风道统一带走热量(HGX A100-80GB 定制散热方案 CTS SKU 官方脚注可支持至 500W[1]);PCIe 版为 300W 双槽风冷插卡,官方同时提供单槽液冷变体[1]。对采购方的含义:SXM 整机(DGX/HGX)要对机房的电力与风道做整柜规划,PCIe 版则是老机房加卡的最低门槛路径。
MIG 是 A100 在部署上留给今天的遗产:单卡最多切 7 个 10GB 实例、各自带 QoS 保障,配合 Kubernetes 与容器编排(官方页口径[1]),小团队可以把一张退役 A100 拆给多个推理服务用——这也是它在二手市场仍有人接手的原因之一。
模型适配MODEL FIT
| 模型 / 场景 | 显存需求(FP16 估算) | A100 部署(8 卡 640GB) | 萬安指数 |
|---|---|---|---|
| DeepSeek R1 满血(671B) | FP16 约 1.3TB / FP8 约 690GB | 装不下——A100 亦无 FP8,FP16 八卡仅 640GB;跨机部署或量化后另行评估 | 38 |
| 70B 级开源模型 | FP16 约 140GB | 单卡 80GB 装不下,双卡张量并行起步;INT8 量化后单卡临界(KV cache 需精打) | 70 |
| 7B-14B 级 | FP16 约 14-28GB | 单卡轻松,批量产线靠 MIG 切片或多卡堆并发 | 88 |
| 科学计算 / FP64 仿真 | 视网格规模 | FP64 Tensor 19.5 TFLOPS + 80GB 显存,A100 的传统优势阵地 | 85 |
显存按 FP16 权重 ≈ 参数量 × 2 字节估算(推算口径,未含 KV cache 与激活余量);A100 不支持 FP8,向 FP8 迁移的产线请直接看 H100/H200。萬安指数为本库估算口径,随实测更新。
图集GALLERY
实拍图随验货批次上架持续补充;AI 生成图不冒充实拍。
软件与生态ECOSYSTEM
| 项目 | 要求 / 现状 |
|---|---|
| CUDA | 11.0 起支持 Ampere(首发版本),现役 12.x 全覆盖 |
| 驱动 | 450 系起(首发),现役驱动持续兼容 |
| 训练框架 | PyTorch / TensorFlow 官方支持 Ampere,生态最成熟的世代之一 |
| 推理引擎 | vLLM / SGLang / TensorRT 均支持,但公开评测基准机型已让位 H100 |
| MIG 配套 | 与 Kubernetes、容器编排协同(官方页口径),多租户切分的成熟方案 |
| 操作系统 | 主流 Linux 发行版(Ubuntu 20.04+ 等) |
Ampere 生态经六年沉淀极成熟,存量代码库兼容性最好;软件栈版本随时间演进,以 NVIDIA 官方发布为准。EOL 后驱动与安全更新节奏需在采购前与原厂/渠道确认。
采购与验货PROCUREMENT
A100 采购的验货要点(三项):
完整六项压测判例(数值为 A100 实锚)见本词条「如何压测」节。
如何压测BENCH TEST
六项压测口径,数值判例全部按 A100 实锚:开箱识别 → 单卡烤机(SXM 400W / PCIe 300W,≤85℃ 零 ECC 合格)→ 全机满载 → 显存带宽(SXM 标称 2,039GB/s,≥85% 合格)→ 互联带宽(NVLink 标称 600GB/s,nccl-tests ≥500GB/s)→ 推理吞吐(≥公开基准 80%)。
运输与交付LOGISTICS
OEM 与变体VENDORS
同一块 HGX A100 基板,各家整机差在形态、散热与服务;ChatGPT 算力潮时期的 8×A100 整机盘点(Supermicro / Inspur / ASUS / Dell / Gigabyte)可作存量机的形态对照[11]:
| 整机厂 | 代表形态 | 差异点 | 2026 年现状 |
|---|---|---|---|
| Supermicro 超微 | HGX A100 8 整机(风冷 / 液冷) | 走量主力,形态齐全 | 存量与退役机流通 |
| Dell 戴尔 | PowerEdge 系(HGX A100 8) | 全球一线服务网络 | 存量流通 · 看服务合同 |
| Inspur 浪潮 | NF5488A5 等(HGX A100 8) | 亚太与国内项目常见,专业媒体有完整评测 | 国内存量主力 |
| Gigabyte 技嘉 | HGX A100 8 整机 | 配置灵活,亚太渠道强势 | 存量流通 |
| NVIDIA 官方 | DGX A100(8 卡整机) | 官方一体交付,全栈软件与原厂背书 | EOL · 原厂渠道收尾 |
整机厂信息来自各家官方发布与公开评测(如 ServeTheHome[11]);各整机厂当前主力产品线已转向 Hopper/Blackwell 平台(各家官方产品线口径),A100 整机以存量与退役机流通为主。具体型号以厂商官方发布为准。
术语卡GLOSSARY
HBM2e 显存
第二代高带宽显存的增强版。A100 80GB 版单卡 80GB HBM2e、SXM 带宽 2,039GB/s——HBM2e 也是 A100 与后继机型拉开代差的地方:H100 起换 HBM3/HBM3e,容量与带宽双双翻倍以上。
MIG 多实例 GPU
A100 首创的单卡切分能力:最多 7 个实例、80GB 版单实例最高 10GB 显存,各实例独立隔离并带 QoS 保障。多租户推理与云端小模型产线的实用特性,验货时 MIG 能否正常切分也应列入测试项。
NVLink 3 / SXM4
第三代 NVLink 单卡 600GB/s,SXM4 板载封装(GPU 焊在 HGX 基板上)配合 NVSwitch 让 8 卡全互联;PCIe 版经桥接器仅双卡 600GB/s——互联形态是 SXM 与 PCIe 版价差的核心。
TF32 与结构性稀疏
A100 首发的两项精度技术:TF32 让单精度训练免改代码提速;结构性稀疏(官方以星号标注的口径)把算力标称翻倍,但需模型配合剪枝,dense 口径减半——看算力标称先问稀疏与否。
A800 与管制批次
A800 是 A100 的对华特供衍生(互联带宽降档以符合 2022-10 管制阈值),2023-10 升级管制后与 A100 一并纳管。批次与报关路径影响保修与保值,验货必查;本库表述均为公开报道口径,不构成法律意见。
局限与争议LIMITS
- 显存与带宽代差:80GB HBM2e / 约 2TB/s,被 H200(141GB / 4.8TB/s)与 B300(288GB / 约 8TB/s)大幅反超;A100 亦无 FP8——「R1 满血装不下」只是最出名的例子(推算口径,见「模型适配」),这是它与后继机型选型分界的根因。
- 对华管制史主角:2022-10 联邦公报规则将 A100 纳入对华许可管理[5],特供 A800 于 2023-10 一并纳管[6],此后再未回到对华获批清单(2025-12 获批对华的是 H200[12])——大陆正规渠道无新卡公开销售,现货流通属存量与灰色渠道(公开报道口径[8])。本库仅记录公开报道口径,不构成法律意见。
- EOL 与备件风险:渠道于 2024 年初收到 A100 全系 EOL 通知(渠道转述口径,原厂未见公开新闻稿[9])——保修在期性、备件通道与固件更新节奏都是采购前必须逐项确认的硬约束。
- 二手退役机的翻新风险:存量流通以数据中心退役机与渠道库存为主,翻新与「40GB 冒充 80GB」风险并存;围绕高端 GPU 的灰市与走私案件见于公开报道[8][10]——序列号独立验真 + 显存实测是必要程序。
- 400W 功耗与机房门槛:SXM 版 400W(CTS SKU 最高 500W,官方脚注[1])、8 卡整机 GPU 合计满载约 3.2kW(推算口径),被动散热依赖整机风道——老机房直接加卡不如 PCIe 版(300W 双槽)现实,部署前先算电力与散热账。
- 「矿卡」问法的误导:A100 无显示输出、非挖矿主力,「无矿」问法意义有限(本库验货经验口径,属行业常识判断);真实风险是数据中心 7×24 高负载老化与退役翻新——正确的问题是「机房负载史与上电时长」,而不是「有没有挖过矿」。
行情说明MARKET NOTE
A100 已进入产品线尾声(EOL 渠道口径[9]),现货以存量机、退役机与渠道库存为主,成色、保修、机房负载史与渠道条件让价格离散度极大——没有可复核的统一行情,本库诚实原则:不做行情带,价格以货主实际报价为准。
在售检索:萬安算交所大厅 ›(0 佣金撮合、不参与交易,不掌握亦不推测成交价,数据因此中立)。行情快照积累充分后本节将切换为标准行情带。
价格节点大事记MILESTONES
常见问题FAQ
看价格与保修:推理(尤其 7B-14B 级与 MIG 切片多租户)和传统 HPC/FP64 场景它仍然能打,Ampere 生态是各世代里最成熟的之一;但产品线已 EOL(渠道口径),保修、备件与保值是硬约束。预算充足或要 FP8 产线,直接看 H100/H200。
同为 80GB 起步,但整整差一代:HBM2e 约 2TB/s 对 HBM3 3.35TB/s,NVLink 600GB/s 对 900GB/s,FP64 Tensor 19.5 对 67 TFLOPS,且 H100 首发 FP8/Transformer Engine——训练与推理效率都拉开代差。A100 的独特阵地是成熟生态与二手价差。
A100 自 2022 年 10 月起被纳入美国对华出口管制,特供 A800 也于 2023 年 10 月一并纳管;中国大陆正规渠道无新卡公开销售,现货流通属存量与灰色渠道。本条为公开报道口径,不构成法律意见,采购前请以主管部门政策与专业合规意见为准。
nvidia-smi 一锤定音:A100-SXM4-80GB / A100-PCIE-80GB 与 40GB 版命名直接可辨;再以丝印、官方固件报告与显存实测三件套交叉核验——仅凭照片不可靠(见「采购与验货」与「如何压测」)。
A100 无显示输出、算力卡挖矿经济性差,不是挖矿主力,「无矿」问法意义有限;真实风险是数据中心 7×24 高负载老化与退役翻新。买二手的正确姿势:问机房负载史与上电时长、核 EOL 后保修状态、走六项压测(显存与互联带宽实测是重点)。
相关词条SEE ALSO
机型对比与选型COMPARE
参考资料REFERENCES
- NVIDIA 官网 — A100 产品页(规格主档,2026-10 实抓) https://www.nvidia.com/en-us/data-center/a100/
- ServeTheHome — NVIDIA A100 80GB Brings Double the Memory(2020-11-16 发布报道与模组图) https://www.servethehome.com/nvidia-a100-80gb-brings-double-…
- TechPowerUp GPU 数据库 — NVIDIA A100 PCIe 80GB(第二源,2021-06 渠道记录口径) https://www.techpowerup.com/gpu-specs/a100-pcie-80-gb.c3623
- NVIDIA — NVIDIA Ampere Architecture 白皮书(GA100,2020-05) https://images.nvidia.com/aem-dam/en-zz/Solutions/data-cente…
- 联邦公报 — FR 2022-21658:对华先进计算出口管制规则(2022-10-13) https://www.federalregister.gov/documents/2022/10/13/2022-21…
- 联邦公报 — FR 2023-23055:管制升级,A800/H800 纳管(2023-10-25) https://www.federalregister.gov/documents/2023/10/25/2023-23…
- 美国国会研究处 — CRS R48642: U.S. Export Controls and China: Advanced Semiconductors(对华管制时间线) https://www.congress.gov/crs-product/R48642
- Reuters — China's military and government acquire Nvidia chips despite US ban(2024-01-14,灰市流通口径) https://www.reuters.com/technology/chinas-military-governmen…
- AMAX(渠道)— H100 vs A100 对比(2024 年初 A100 全系 EOL 通知,渠道转述口径) https://amaxai.ghost.io/nvidia-h100-vs-nvidia-a100
- IMD — Semiconductor export controls: What chip smuggling reveals(2026,灰市与走私观察) https://www.imd.org/ibyimd/geopolitics/the-long-way-to-china…
- ServeTheHome — ChatGPT Hardware: A Look at 8x NVIDIA A100 Systems(8×A100 整机盘点) https://www.servethehome.com/chatgpt-hardware-a-look-at-8x-n…
- 东方财富网转腾讯科技 — H200 获批对华(2025-12-24,同 H100 词条 [9] 口径)
- 在售检索 — 萬安算交所(0 佣金撮合;A100 暂无行情快照,价格以货主报价为准) https://www.aixx.vip/hall.html