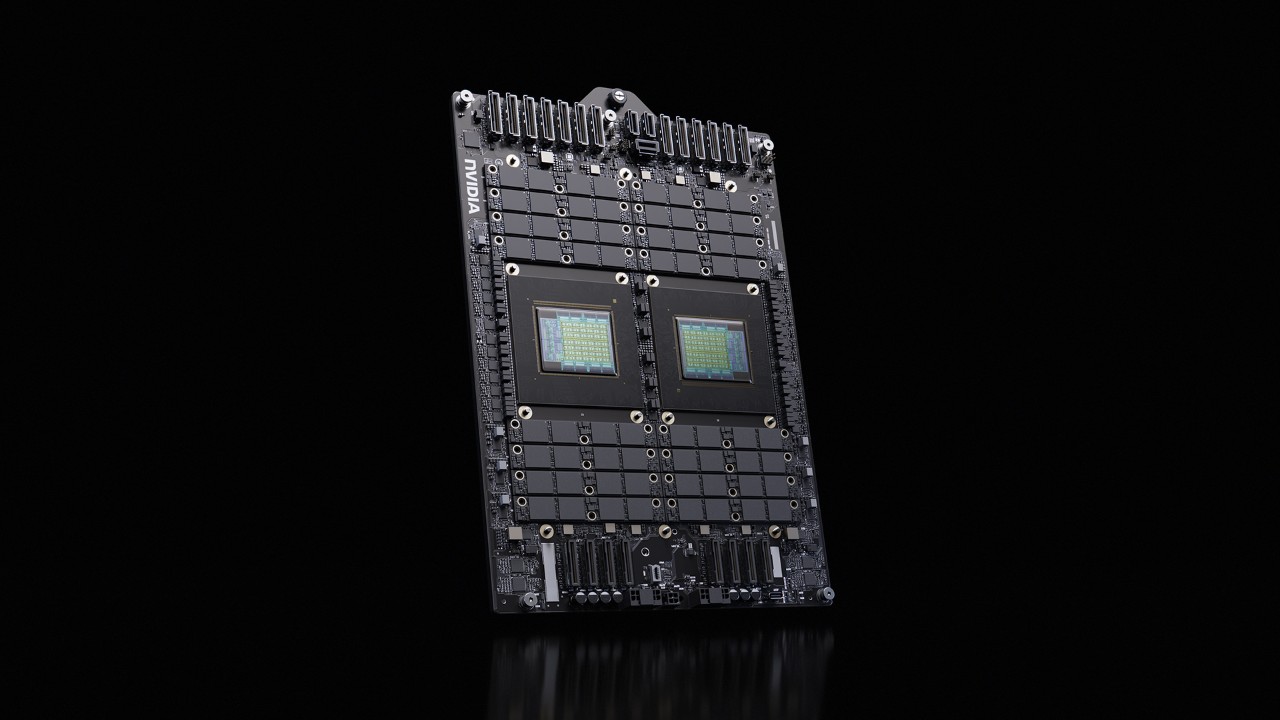
GH200
概述OVERVIEW
GH200(Grace Hopper Superchip)是 NVIDIA 第一代CPU+GPU 超级芯片:1 颗 Grace CPU(72 核 Arm Neoverse V2)与 1 颗 Hopper GPU(H100 级 Tensor Core)经 NVLink-C2C(900GB/s 一致性带宽,相当于 7× PCIe Gen5)封装为一体——CPU 侧 480GB LPDDR5X 与 GPU 侧 96GB HBM3(或 144GB HBM3e)构成合计最高 624GB 快速内存(官方 datasheet 口径[2])。
它是科学计算与 AI 混合负载的战绩机型:2023 年 5 月全面投产(COMPUTEX 口径[3]),2024 年全球 9 台新超算采用 GH200(ISC 口径合计 200 EFLOPS 能效 AI 算力[5]),Green500 能效榜首 JEDI(JUPITER 开发机)正是 GH200 驱动(TOP500 口径[6])——「能效」与「大内存一致性」是它区别于纯 GPU 卡的两张牌。
2026 年的现货市场,GH200 以 DGX GH200 整机、NVL2 变体与单超芯片模组多形态流通(以科研与云项目存量为主)。采购是系统级工程(Arm 软件栈+C2C 验收),本词条不带行情带——价格以货主实际报价为准。
适用场景FIT
萬安指数(0–100):按 CPU-GPU 协同场景加权(超级芯片特化口径)。
沿革HISTORY
2022 年 5 月 30 日,ISC 2022:NVIDIA 宣布 Grace Hopper 平台与首批 OEM 伙伴(Atos/Eviden 前身、Dell、GIGABYTE、HPE、浪潮等,NVIDIA 新闻稿[4])——Grace 品牌从预告进入产品节奏。
2023 年 5 月 28 日,COMPUTEX 双响:GH200 宣布全面投产(Cisco/Dell/HPE 等加入,新闻稿[3]);同场发布 DGX GH200——256 颗 GH200 经 NVLink Switch System 全互联,1 EFLOPS + 144TB 共享显存的 AI 超算(新闻稿[7])。
2023 年 8 月 8 日,SIGGRAPH 升级:新一代 GH200 搭载全球首款 HBM3e 处理器(144GB HBM3e 版本,双芯片配置 144 个 Arm 核心口径,新闻稿[8])——GH200 的显存档位再上台阶。
2023-2025 年,科学超算收割期:欧洲旗舰 JUPITER 由 GH200 驱动(SC23 宣布,新闻稿[5]);ISC 2024 宣布全球 9 台新超算采用(合计 200 EFLOPS 能效 AI 算力);Green500 榜首 JEDI 与 TOP500 第 4 的 JUPITER Booster(793.4 PFlop/s 初测,TOP500 2025-06 口径[6])相继验证。
2026 年,现货定位:GH200 以科研存量与云项目余量流通,接棒者是 Grace Blackwell(GB200 系,见词条)。超级芯片类设备的跨境流通政策仍在演进,本库表述为公开报道口径、不构成法律意见。
技术规格SPECIFICATIONS
| 项目 | 规格(GH200 · 官方 datasheet 口径,双显存版本分列处已注明) |
|---|---|
| 超芯片构成 | 1× Grace CPU + 1× Hopper GPU · NVLink-C2C 单封装(风冷/液冷) |
| CPU | 72 核 Arm Neoverse V2 · 基础 3.1GHz / SIMD 3.0GHz · L3 114MB |
| GPU 显存 | 96GB HBM3(4TB/s)或 144GB HBM3e(4.9TB/s;市场常称 141GB 可用,datasheet 口径 144GB) |
| CPU 内存 | 480GB LPDDR5X ECC(另有 120GB/240GB 档)· 384-512GB/s |
| 快速内存合计 | 最高 624GB(CPU+GPU,datasheet 口径[2]) |
| NVLink-C2C | 900GB/s 一致性带宽(=7× PCIe Gen5;较 PCIe 互联功耗降 5× 以上,新闻稿口径[3]) |
| FP64 / FP64 Tensor | 34 / 67 TFLOPS |
| FP32 | 67 TFLOPS |
| FP8 Tensor Core | 3,958 TFLOPS(稀疏)/ 1,979 TFLOPS(稠密) |
| BF16/FP16 Tensor | 1,979 TFLOPS(稀疏)/ 990 TFLOPS(稠密) |
| INT8 | 3,958 TOPS(稀疏)/ 1,979 TOPS(稠密) |
| 功耗 | 可配置 450-1000W(内存+CPU+GPU 合计,非固定 TDP) |
| PCIe | 最高 4× PCIe Gen5 x16 |
| 变体 | GH200 NVL2(双超芯片 NVLink 互联 · 144 核/288GB HBM3e/1.2TB 快存) |
规格以 NVIDIA 官方 datasheet 为准(C4 实抓快照 2026-10[2]);系统级形态 DGX GH200=256×GH200 全互联(1 EFLOPS+144TB 共享显存,新闻稿口径[7])。
超级芯片三代对照THREE GENERATIONS
| 项目 | GH200(Grace Hopper) | GB200(Grace Blackwell) | GH200 vs GB200 一句话 |
|---|---|---|---|
| 组合 | Grace + Hopper GPU | Grace + 2× B200 | Hopper 代对 Blackwell 代 |
| GPU 显存 | 96GB HBM3 / 144GB HBM3e | 192GB HBM3e ×2 | Blackwell 显存翻倍 |
| 快速内存合计 | 624GB | GB200 口径见词条 | 两者同走 C2C 一致性路线 |
| 精度主打 | FP64/FP8 双修(HPC+AI) | FP4/FP8(AI 极致) | HPC 选 GH200、AI 极致选 GB200 |
GB200 详见词条;GH200 的 FP64 优势(34/67 TFLOPS)是它与 Blackwell 代拉开差异的独特阵地。
家族成员FAMILY
超级芯片家族按组合世代分档;GH200 是第一代量产主力:
散热与部署COOLING
GH200 提供风冷与液冷双形态(官方 datasheet 口径[2]),功耗可配置 450-1000W(内存+CPU+GPU 合计)——「可配置功耗」是它的部署特点:同一颗超芯片的功耗档位随内存配置与 GPU 档位变化,机柜电力按实际配置核算。DGX GH200 级系统则是机房级液冷工程(同 NVL72 词条口径)。
软件部署的特别项:Arm CPU 侧工具链盘点(同 Grace CPU 词条口径)+ C2C 一致性内存的编程模式(CUDA 统一内存视角)——GH200 的性能红利要靠「把数据留在 624GB 一致性池里」的架构设计兑现,传统「CPU 准数据、GPU 算数据」的代码不改也能跑但吃不满(本库整理口径)。
场景适配WORKLOAD FIT
| 负载 | GH200 的表现口径 | 萬安指数 |
|---|---|---|
| HPC-AI 融合超算 | Green500 榜首战绩(JEDI)+ FP64 34/67 TFLOPS——能效与双精度双修 | 92 |
| 向量检索 / RAG | 官方口径:RAG 嵌入生成较 x86+H100 PCIe 组合 30×(产品页口径[1])——624GB 一致性池的直接受益者 | 90 |
| 推荐系统 / GNN | 官方口径 GNN 训练最高 8×(产品页口径[1])——大 embedding 表吃一致性内存 | 88 |
| 通用 CUDA 产线平移 | 能跑但吃不满——C2C 架构红利需要按一致性内存重新设计数据流 | 62 |
负载口径来自 NVIDIA 官方产品页与公开战绩[1][6](厂商口径,不构成性能承诺);实际收益以自有机房压测为准。
图集GALLERY
软件与生态ECOSYSTEM
| 项目 | 要求 / 现状 |
|---|---|
| CUDA 兼容 | Hopper GPU 侧 CUDA 原生——存量 CUDA 代码可跑,C2C 一致性内存需按统一内存模式重构才能吃满 |
| 操作系统 | 主流 Linux Arm 版(同 Grace 词条口径) |
| 集群软件 | DGX GH200 走 Base Command 系;学术超算多用 Slurm 系调度(JUPITER 等公开案例口径) |
| HPC 栈 | FP64/FP32 HPC 库(cuSolver 系)+ MPI——传统超算用户迁移友好度高于纯 AI 集群 |
| 战绩参照 | TOP500/Green500 公开榜单(JEDI/JUPITER 等公开系统口径[6]) |
GH200 的生态位是「科学超算×AI」交叉带;版本随时间演进,以 NVIDIA 官方发布为准。
采购与验收PROCUREMENT
GH200 采购的验收要点(三项):
验收速查QUICK CHECK
GH200 四步速查:
运输与交付LOGISTICS
术语卡GLOSSARY
超级芯片(Superchip)
CPU+GPU 单封装组合的产品形态:GH200(Grace+Hopper)开先河,GB200(Grace+2×B200)接棒——封装内 C2C 互连让「跨设备拷贝」变成「一致性内存访问」。
NVLink-C2C 900GB/s
GH200 的 CPU-GPU 一致性带宽:官方口径相当于 7× PCIe Gen5,且较 PCIe 互联功耗降 5× 以上(新闻稿口径)——「带宽翻 7 倍、功耗降 5 倍」是超级芯片价值的量化注脚。
624GB 快速内存
GH200 的 CPU LPDDR5X(480GB)+ GPU HBM(96/144GB)在一致性视角下合计的「快速内存池」——向量检索、大 KV cache、大 embedding 的容量底气(datasheet 口径)。
DGX GH200
256 颗 GH200 经 NVLink Switch System 全互联的系统级旗舰:1 EFLOPS+144TB 共享显存(新闻稿口径)——GH200 生态的塔尖形态,验证了超芯片路线的规模化上限。
Green500
全球能效超算榜单:GH200 驱动的 JEDI(JUPITER 开发机)登顶 2024-11 期榜首(TOP500 口径)——能效是科学超算选型的硬指标,也是 GH200 战绩的含金量所在。
局限与争议LIMITS
- C2C 红利需要架构配合:传统「CPU 准数据、GPU 算数据」的代码在 GH200 上能跑但吃不满——一致性内存的数据流重构是兑现性能的前置条件(本库整理口径)。
- Arm 软件栈盘点:同 Grace CPU 词条口径——企业长尾软件的 Arm 版可用性逐个确认,摩擦点在自研与遗留组件。
- 功耗可配置的双刃剑:450-1000W 的配置弹性意味着「同一型号不同档」——采购合同必须写明功耗配置档位,机房规划按到货配置复核(datasheet 口径[2])。
- 接棒世代的残值压力:GB200 系已放量(Blackwell 代),GH200 的 FP64/能效独特阵地仍在但 AI 主战场的代差在拉开——残值评估按科学计算与 AI 两类需求分开看(本库整理口径)。
- 跨境流通政策变量:超级芯片类设备属管制敏感机型(公开报道口径)——本库仅作政策演进提醒,不构成法律意见。
行情说明MARKET NOTE
GH200 以科研存量与云项目余量流通,形态(模组/NVL2/DGX 系统)与功耗配置让价格离散度大——本库诚实原则:不做行情带,价格以货主实际报价为准。
在售检索:萬安算交所大厅 ›(0 佣金撮合、数据因此中立)。
价格节点大事记MILESTONES
常见问题FAQ
看负载谱:HPC-AI 融合与 FP64 需求(GH200 的 FP64 34/67 TFLOPS + Green500 能效战绩)选 GH200;纯 AI 极致算力与显存(FP4/288GB×2)选 GB200。两者同走 C2C 一致性路线,软件栈同源。
关键在架构设计:把向量表、KV cache、embedding 等「CPU 侧热点」放进一致性内存池直接吃 C2C 带宽——传统「CPU 只做调度」的用法吃不到红利。官方向量检索/RAG/GNN 的提速口径都基于这个模式。
GPU 侧 CUDA 原生可跑(Hopper 架构);CPU 侧是 Arm——宿主软件要 Arm 版,跨 CPU-GPU 的一致性内存编程按 CUDA 统一内存模式设计。存量代码能跑,吃满性能要重构数据流。
四步:双识别(lscpu+nvidia-smi)→ C2C 带宽实测(900GB/s 档 ≥85% 合格,推算口径)→ HBM/LPDDR5X 双池带宽实测 → 目标负载实跑(向量检索/GNN/HPC 基准)。C2C 异常是封装级硬伤,退换窗口内处理。
分用途:科学超算与 HPC-AI 融合负载,GH200 的能效与 FP64 阵地仍在服役高峰(JUPITER 等大系统持续运行);纯 AI 训练产线 GB200 代差明显。二手残值按「HPC 价值」评估而非「AI 旗舰」评估。
相关词条SEE ALSO
机型对比与选型COMPARE
参考资料REFERENCES
- NVIDIA 官网 — GH200 Grace Hopper Superchip 产品页(现行性能口径,2026-10) https://www.nvidia.com/en-us/data-center/grace-hopper-superc…
- NVIDIA 官方 — GH200 Datasheet PDF(规格主档,C4 实抓快照 2026-10) https://www.nvidia.com/en-us/data-center/grace-hopper-superc…
- NVIDIA Newsroom — GH200 Enter Full Production(2023-05-28 COMPUTEX) https://nvidianews.nvidia.com/news/nvidia-grace-hopper-super…
- NVIDIA Newsroom — DGX GH200 AI Supercomputer(256×GH200/1 EFLOPS) https://nvidianews.nvidia.com/news/nvidia-announces-dgx-gh20…
- NVIDIA Newsroom — GH200 with HBM3e(2023-08-08 SIGGRAPH) https://nvidianews.nvidia.com/news/gh200-grace-hopper-superc…
- TOP500 — 2024-11 Green500 榜首 JEDI(GH200 能效战绩) https://www.top500.org/lists/top500/2024/11/highs/
- TOP500 — 2025-06 榜单:JUPITER Booster 793.4 PFlop/s 列全球第 4 https://www.top500.org/lists/top500/2025/06/highs/
- 在售检索 — 萬安算交所(0 佣金撮合;GH200 暂无行情快照,价格以货主报价为准) https://www.aixx.vip/hall.html