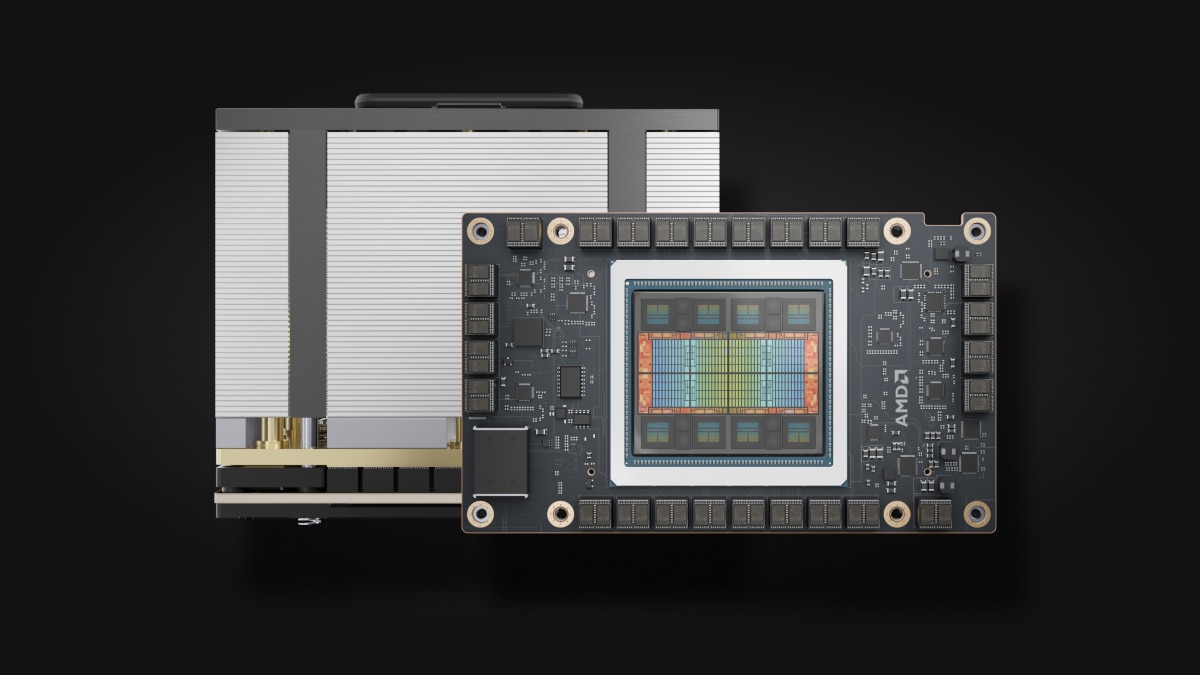
MI325X
概述OVERVIEW
MI325X是 AMD Instinct 系的大显存新旗舰:2024 年 10 月发布——256GB HBM3E 单卡显存、6TB/s 带宽(较 MI300X 的 192GB/5.3TB/s 双双提升),FP8/INT8 算力 2.61 PFLOPS 与 MI300X 同档,OAM 模组、1000W 峰值功耗、8 条 Infinity Fabric 链路组网(AMD 官方规格快照口径[1])。
它的市场叙事是「显存军备竞赛」的 AMD 应手:大模型推理的 KV cache 与长上下文把显存需求一路推高,MI325X 的 256GB 单卡显存对 NVIDIA H200(141GB)形成容量差——配合 ROCm 生态的持续成熟,成为 2025-2026 年 AMD 阵营在推理侧的旗舰答卷(AMD 产品页口径[2])。
2026 年的现货市场,MI325X 随整机方案放量流通:8 卡 OAM 整机是主流交付形态。买它的核心三问:ROCm 版本对卡的支持矩阵、整机方案(UBB 基板+1000W 供电散热)配套、与 MI300X 的价差是否匹配 33% 的显存提升。本词条不带行情带——价格以货主实际报价为准。
适用场景FIT
萬安指数(0–100):本库按公开规格加权估算——显存 40% + 互联 30% + 生态 30%。
沿革HISTORY
2024 年 6 月,AMD 在 Advancing AI 大会预告 MI325X:256GB HBM3E、6TB/s 带宽——「一年一代」的显存军备节奏首次明牌(AMD 发布口径[2])。
2024 年 10 月 10 日,MI325X 正式发布并进入量产节奏:与 MI300X 同芯(CDNA3 架构微调)、显存代际升级——256GB 对 192GB 提升 33%,带宽 6TB/s 对 5.3TB/s(AMD 官方规格快照口径[1])。
2025-2026 年,放量流通:8 卡 OAM 整机方案(UBB 基板 1000W 供电散热)随云与智算中心项目落地,ROCm 6.x 对 MI325X 的支持矩阵成熟——AMD 阵营的推理旗舰进入现货市场(本库整理口径)。跨境流通政策仍在演进,采购时以主管部门政策与专业意见为准(公开报道口径)。
技术规格SPECIFICATIONS
| 项目 | 规格(AMD Instinct MI325X · 官方口径) |
|---|---|
| GPU 架构 | AMD CDNA3(TSMC 5nm | 6nm FinFET) |
| 单卡显存 | 256GB HBM3E |
| 显存带宽 | 6TB/s(8192-bit) |
| FP8 / INT8 | 2.61 PFLOPS / 2.6 POPs |
| FP16 | 1.3 PFLOPS |
| FP32 / FP64 | 163.4 TFLOPS / 81.7 TFLOPS |
| 流处理器 / LLC | 19,456 / 256MB |
| 卡间互联 | Infinity Fabric 8 链路 · 单链路 128GB/s |
| 主机接口 | PCIe Gen5 x16 |
| 形态 / 散热 | OAM 模组 · 被动散热 |
| 功耗 | 1000W Peak |
| 发布 | 2024-10-10(Advancing AI 口径) |
规格以 AMD 官方快照为准(2026-10 口径[1],与本库薄卡逐条对账一致)。
AMD 旗舰两代对照TWO GEN
| 项目 | MI300X | MI325X(本词条) |
|---|---|---|
| 显存 | 192GB HBM3 | 256GB HBM3E |
| 带宽 | 5.3TB/s | 6TB/s |
| FP8 | 2.61 PFLOPS | 2.61 PFLOPS |
| 功耗 | 750W Peak | 1000W Peak |
| 选型一句话 | 存量性价比 | 显存优先新购 |
MI300X 详见词条;算力同档、显存与功耗升级是 MI325X 的升级主轴(各自官方快照口径)。
家族成员FAMILY
Instinct 家族按世代与定位分档;MI325X 是现役显存旗舰:
散热与部署COOLING
MI325X 是 OAM 模组 + 被动散热 + 1000W Peak——散热形态只有整机方案一条路:8 卡 UBB 基板整机、机柜级风道或液冷配套,1000W×8=8kW 级的机柜散热与供电(母排 54V UBB 方案)要整体规划(薄卡官方快照口径[1])。普通 PCIe 工位插卡不存在的——买 MI325X 就是买整机方案。
部署前置三对表:供电(8kW 级 GPU 合计+系统 overhead,机柜电力按整机额定复核)、散热(1000W 单卡的风道或液冷配套)、ROCm 版本(6.x 对 MI325X 的支持矩阵,框架兼容性核对,同 ROCm 词条口径)。
模型适配MODEL FIT
| 模型 / 场景 | 显存需求(FP16 估算) | MI325X 部署口径 | 萬安指数 |
|---|---|---|---|
| 70B 级推理(FP16) | 约 140GB | 单卡 256GB 直装 + 大 KV cache 余量 | 90 |
| DeepSeek R1 满血(671B) | FP8 约 690GB | 8 卡 2TB 装得下且余量充足(FP8 路径随 ROCm 框架支持) | 86 |
| 超长上下文推理 | KV cache 随长度线性 | 256GB 的 KV cache 空间是 MI 系的看家本领 | 90 |
| 大模型训练 | 跨机多集群 | 8 卡 IF 组网可训,调优人力成本计入(ROCm 词条口径) | 78 |
显存按 FP16 权重 ≈ 参数量 × 2 字节估算(推算口径);FP8 路径以 ROCm 框架实际支持为准。
图集GALLERY
软件与生态ECOSYSTEM
| 项目 | 要求 / 现状 |
|---|---|
| 软件栈 | ROCm 6.x(支持矩阵以官方文档为准,同 ROCm 词条口径) |
| 框架 | PyTorch ROCm 版 / vLLM / SGLang——推理生态可用(MI300X 系案例外溢) |
| 虚拟化 | SR-IOV 支持(官方规格快照口径[1]) |
| 观测工具 | rocm-smi / amd-smi |
| 对照 | CUDA 生态对照详见 ROCm 词条迁移框架 |
生态信息为公开口径整理;版本随时间演进,以 AMD 官方发布为准。
采购与验货PROCUREMENT
MI325X 采购的验货要点(三项):
验收速查QUICK CHECK
MI325X 四步速查:
运输与交付LOGISTICS
术语卡GLOSSARY
HBM3E
第三代高带宽内存的增强版:MI325X 单卡 256GB HBM3E、6TB/s——「一年一代」显存升级节奏的 AMD 应手(对照 MI300X 的 192GB HBM3)。
OAM 模组
OCP Accelerator Module:开放计算的加速卡模组标准——MI325X 的 OAM 形态决定它必须随 UBB 基板整机交付,脱离基板无法独立工作。
1000W Peak
MI325X 的板级功耗峰值:较 MI300X 的 750W 大幅提升——单机 8 卡 8kW 级的散热与供电是机房规划的硬指标(官方快照口径)。
UBB 基板
Universal Baseboard:8 卡 OAM 模组的统一基板——54V 供电母排与 IF 互连的载体,MI325X 整机方案的物理底盘。
局限与争议LIMITS
- ROCm 生态的迁移账:CUDA 存量产线迁移按人月算总账(同 ROCm 词条框架)——MI325X 的显存优势要压过迁移成本才值得动(本库整理口径)。
- 1000W 功耗的机房门槛:8 卡整机 8kW 级 GPU 功耗+系统 overhead——风冷机柜的密度上限与液冷改造预算要前置规划(本库整理口径)。
- 算力同档显存升级的定位:FP8 算力与 MI300X 同档(2.61 PFLOPS)——纯算力需求场景 MI300X 存量更便宜,显存敏感场景才选 MI325X(各自快照口径对照)。
- 二手流通尚早:MI325X 2024 年末才铺货,二手市场标尺未成型——显存健康度与 IF 链路状态是验货重点(本库验货经验口径)。
- 跨境流通政策变量:AMD 高端卡同样在管制语境下(公开报道口径)——跨境采购合规以专业意见为准,本库不构成法律意见。
行情说明MARKET NOTE
MI325X 以 8 卡 OAM 整机流通为主,成色与渠道让价差存在——暂无可复核的统一行情快照,本库诚实原则:不做行情带,价格以货主实际报价为准。
在售检索:萬安算交所大厅 ›(0 佣金撮合、数据因此中立)。
价格节点大事记MILESTONES
常见问题FAQ
显存敏感场景(超长上下文/大 KV cache)选 MI325X:256GB 对 192GB 提升 33%、带宽 6TB/s;预算敏感的存量场景 MI300X 更便宜且算力同档(FP8 均 2.61 PFLOPS)——注意 MI325X 功耗 1000W 对 750W,机房配套要跟上。
FP8 口径可以:R1 满血 FP8 约 690GB,8 卡 MI325X 合计 2TB 显存装得下且余量充足——推理栈用 vLLM/SGLang 的 ROCm 版,部署前先跑基准验证。
不能独立使用:OAM 模组脱离 UBB 基板无法工作——MI325X 以 8 卡整机方案流通,「散卡便宜卖」要高度警惕模组来源与配套完整性。
四步:rocm-smi 身份识别(256GB/序列号)→ 显存带宽实测(6TB/s 档 ≥85% 合格,推算口径)→ 8 卡 rccl-tests 互联 → 1000W 满载烤机温度与 ECC。ROCm 版本支持矩阵核对是采购前置项。
显存与生态的两难:MI325X 256GB 对 H200 141GB 显存占优,但 H200 背靠 CUDA 生态且 NVLink 900GB/s 互联更强——开源栈新产线可评估 MI325X,CUDA 存量产线 H200 迁移成本为零。
相关词条SEE ALSO
机型对比与选型COMPARE
参考资料REFERENCES
- AMD 官网 — Instinct MI325X 产品页(规格主档,官方快照与本库薄卡对账一致,2026-10) https://www.amd.com/en/products/accelerators/instinct/mi300/…
- AMD Newsroom — MI325X 发布相关口径(Advancing AI) https://www.amd.com/en/newsroom.html
- AMD 官方文档 — ROCm 文档站(支持矩阵口径) https://rocm.docs.amd.com/
- 在售检索 — 萬安算交所(0 佣金撮合;MI325X 暂无行情快照,价格以货主报价为准) https://www.aixx.vip/hall.html?model=MI325X