SECTIONS
EDITIONS
NETWORK
萬安百科 › 机型词条 › 海光 深算 K100-AI(DCU)
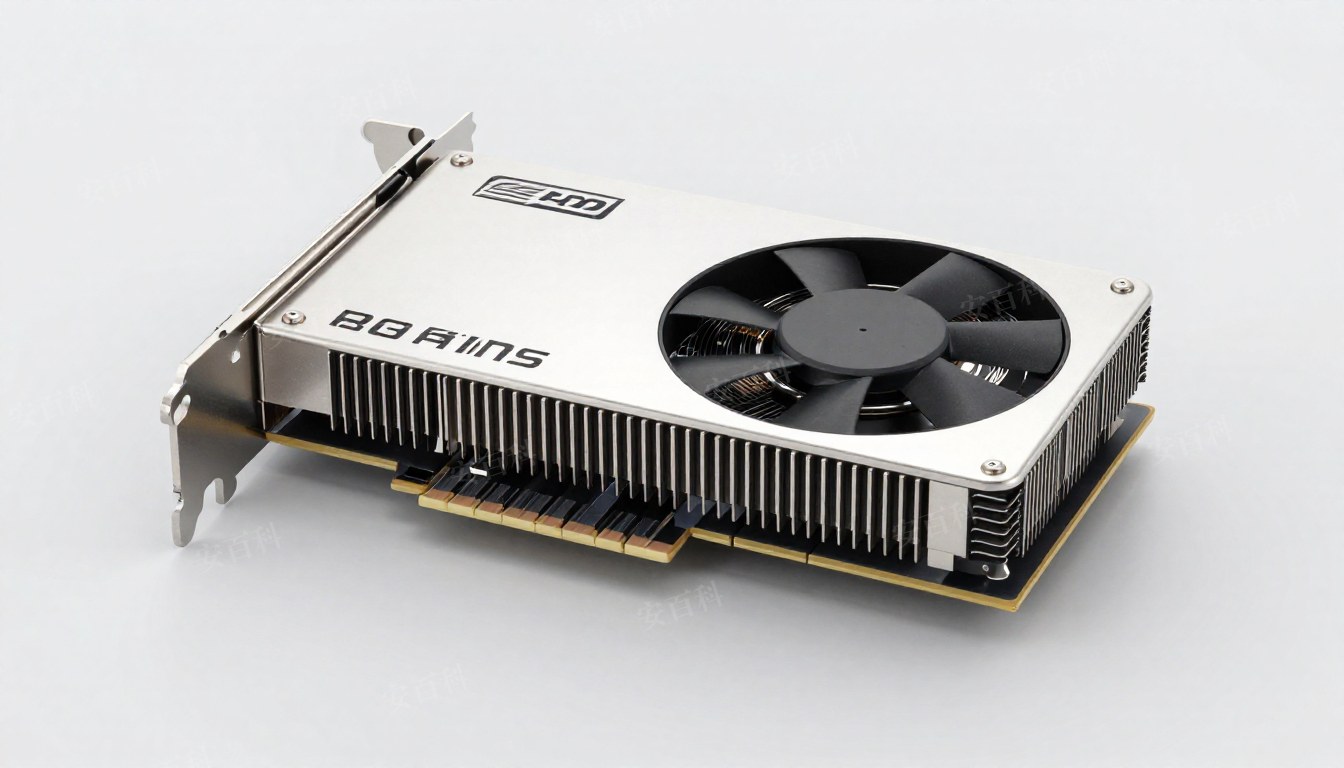
示意配图(AI 生成·非官方产品图)· 萬安百科
海光 深算 K100-AI(DCU)
深算二代 AI 档 · 64GB HBM2e · 类 ROCm/DTK 生态 · 国产算力卡词条
概述OVERVIEW
K100-AI 是海光信息 深算二代家族的 AI 加速卡档(DCU·协处理器路线):多源口径 64GB HBM2e 显存,软件生态走类 ROCm / 海光 DTK 工具链——是国产卡里唯一"从 ROCm 生态 长出来"的路线,PyTorch/Paddle 等框架迁移面较窄栈方案宽(生态文档与开源验证项目口径)。 口径声明:海光官方页公开信息有限(2026-11 核验),完整算力规格表未公开——本词条只立可证事实, 其余逐处标注媒体口径。
沿革HISTORY
- 深算一号:海光 DCU 首代(官方口径的起点代)。
- 深算二号 / K100 系:2023–2024 陆续出货(媒体口径);K100-AI 为补位智算市场的 AI 档(媒体口径)。
- 深算三号:在研/接续(官方口径)——现役流通以二代家族为主。
代际对比GENERATIONS
| 维度 | 深算一号(首代) | 深算二号 / K100-AI(本词条) | 深算三号(接续) |
|---|---|---|---|
| 定位 | DCU 起步代 | 通用 K100 + AI 档 K100-AI 双线 | 在研/接续(官方口径) |
| 显存 | 官方口径为准 | 64GB HBM2e(多源口径) | — |
| 生态 | ROCm 系兼容 | DTK 工具链 · 框架适配案例公开 | — |
口径:官方页公开信息有限(2026-11 核验)——表中只列可证事实,缺项不代填;媒体口径项已标注。
技术规格SPECS
| 项目 | 口径 |
|---|---|
| 家族 | 海光深算二代(DCU 路线) |
| 显存 | 64GB HBM2e(多源口径·完整规格表官方未公开) |
| 算力 | 官方表未公开——媒体口径定位与合规档 H20 相近档,以规格书与实测为准 |
| 软件栈 | DTK 工具链(类 ROCm 生态)· PyTorch / PaddlePaddle 适配案例公开(开源生态文档口径) |
| 互联 | 媒体口径提及高速卡间互联(800Gbps 档报道)——以规格书为准 |
| 部署 | 智算服务器整机与集群项目交付为主(媒体口径) |
模型适配MODEL FIT
| 场景 | 适配口径(推算:权重×精度+开销·64GB HBM2e 基准) |
|---|---|
| 7B–14B 级 | FP16 全量可容;量化档多路并发(推算口径) |
| 30B–70B 级 | INT8/4-bit 量化可容(推算口径)——PaddleNLP 7B 推理为公开验证起点(生态文档) |
| 迁移红利 | ROCm 同源——AMD 栈上的模型资产迁移面较 CUDA 栈窄(生态对照口径) |
更大模型档——去模型广场按需调用
萬安云 · 模型广场 →局限与边界LIMITS
- 官方信息真空:完整规格表未公开——流通卡规格离散风险与 910B 同级,验货实测是硬前提(验货流程)。
- 生态双刃:ROCm 同源是迁移红利也是天花板——上游 ROCm 版本演进节奏不由海光单方控制(生态对照见 ROCm)。
- 流通面:以项目整机交付为主——散卡流通样本少于昇腾系,二手比价参照少。
常见问题FAQ
K100-AI 的算力是多少?
海光官方页公开信息有限(2026-11 核验),完整算力规格表未公开——本词条不代填数字;媒体口径将其定位为与合规档 H20 相近的训练档,采购以厂商规格书与实测为准。
DCU 的软件生态为什么是 ROCm 系?
海光 DCU 架构与 AMD ROCm 生态同源兼容(生态文档口径),海光自研 DTK(DTK 工具链)承接迁移——PyTorch/Paddle 等框架有官方适配案例(PaddleNLP 在 K100_AI 上跑通 7B 推理的公开验证文档)。
K100-AI 和 K100 有什么区别?
同属深算二代家族:K100 为通用计算定位(媒体口径双精度向),K100-AI 为智算 AI 档(64GB HBM2e,多源口径)——买卡认准 AI 后缀与显存配置。