规格词条 · 中卡 STANDARD CARD
NVIDIA L4
推理侧主力低功耗卡,国内现货流通量大,B卡长尾代表
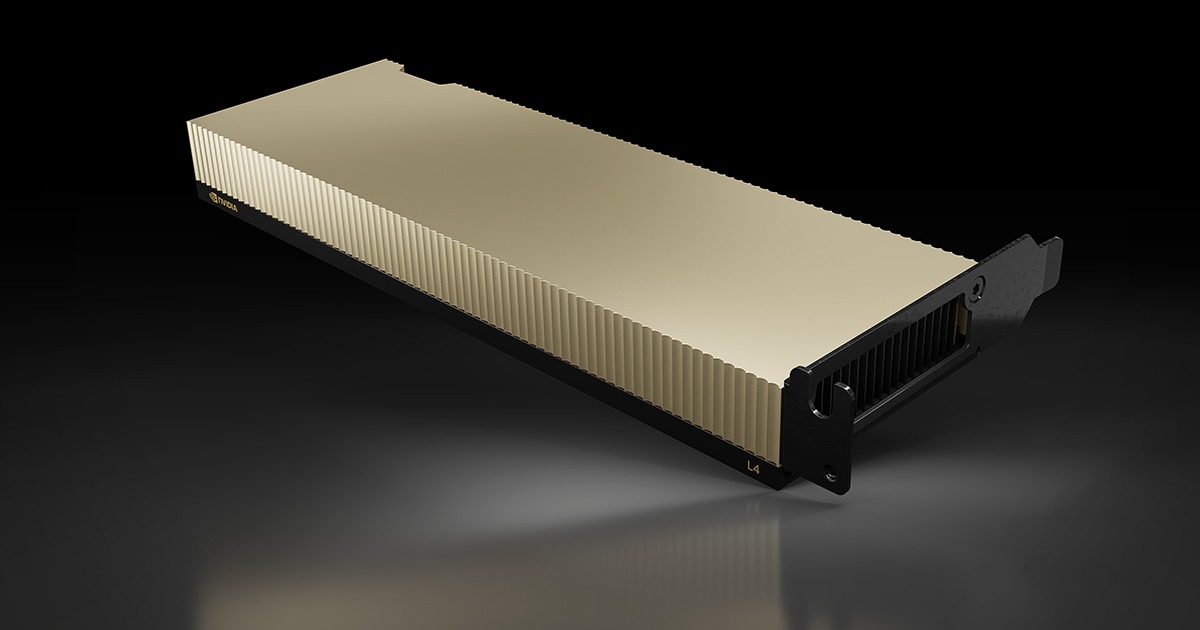
NVIDIA 厂商官方图
实拍
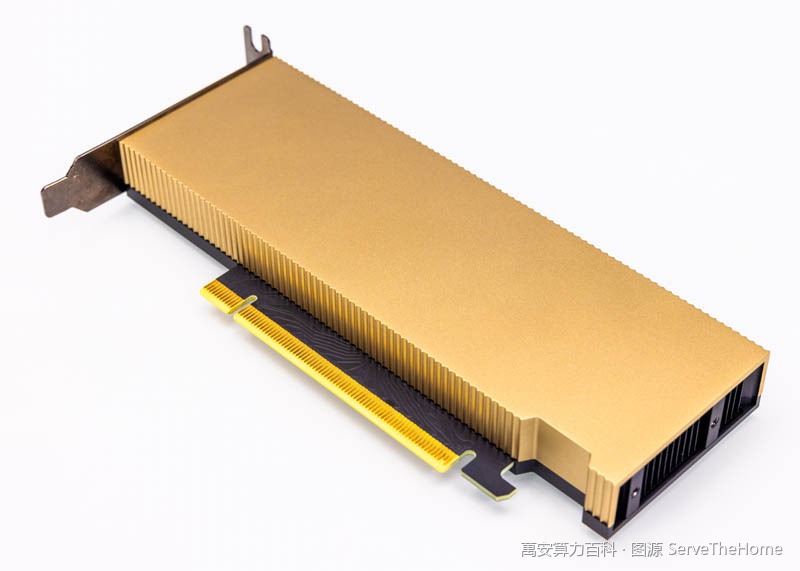
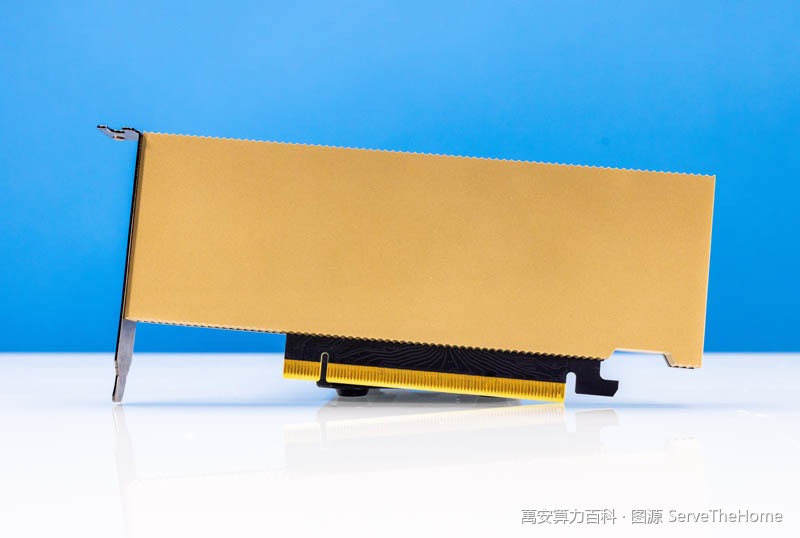
实拍图
概述
NVIDIA L4 是一款面向推理场景的低功耗数据中心 GPU,基于 AD104 芯片,采用 PCIe 接口的单槽低剖面(low-profile)形态。它配备 24GB 显存,显存带宽为 300GB/s,FP32 算力为 30.3 teraFLOPs,FP8 Tensor Core 算力可达 485 teraFLOPS。其 TDP 仅为 72W,可在常规服务器环境中大规模部署,常用于大语言模型推理、图像与视频处理等对能效比较为敏感的工作负载。
核心规格
| 显存 | 24 GB GDDR6 |
| 显存带宽 | 300 GB/s |
| FP32算力 | 30.3 teraFLOPS |
| FP8算力 | 485 teraFLOPS |
| 功耗TDP | 72 W |
| 互联 | PCIe Gen4 x16 |
| 形态 | 1-slot low-profile |
| 编解码器 | NVENC 2 | NVDEC 4 | JPEG 4 |
规格已与官方基准快照对账(基准来源,采集 2026-10-09)· 价格以货主实际报价为准
适用场景
- 大语言模型推理服务:24GB 显存可承载中等规模模型的多实例部署,FP8/INT8 Tensor Core 提供较高的量化推理吞吐
- 视频转码与图像处理:内置 2 个 NVENC、4 个 NVDEC 与 4 个 JPEG 解码器,适合视频点播、直播转码与图像批量处理
- 低功耗高密度部署:72W TDP 与单槽低剖面形态适合部署在供电和散热受限的通用服务器机箱内,提升单机 GPU 密度
- 推荐系统与在线推理 API:PCIe Gen4 x16 互联(64GB/s)满足单机推理场景的数据交换需求,适合构建在线服务后端
同族型号
| 型号 | 显存 | 功耗 |
|---|---|---|
| NVIDIA A30 对比 | 24 GB HBM2 | 165 W |
| NVIDIA L40 对比 | 48 GB GDDR6 with ECC | 300W |
| NVIDIA H200 NVL 对比 | 141GB | Up to 600W (configurable) |
| NVIDIA H800 对比 | 80 GB HBM2e | 350 W |
| NVIDIA H100 NVL 对比 | 94GB | 350-400W (configurable) |
| NVIDIA A2 对比 | 16 GB GDDR6 | 40–60W (configurable) |
采购与验货要点
- L4 为 PCIe 单槽低剖面形态、TDP 72W,通常无需专用散热模组或高功率供电改造,但仍需确认服务器机箱对 low-profile 卡的兼容性以及 PCIe 插槽的物理布局与风道设计
- 该卡采用 PCIe Gen4 x16 互联而非 NVLink,不具备多卡高带宽直连能力,采购前应确认业务是否依赖多卡互联训练;若以推理为主则影响有限
- 注意其显存带宽为 300GB/s,低于同代高端数据中心卡,部署对显存带宽敏感的大模型时应结合模型规模与并发量评估单卡吞吐,避免按 FP32 算力线性推算实际推理性能
常见问题
NVIDIA L4 适合跑多大的大模型推理?
L4 配备 24GB 显存,可完整容纳多数参数量在几十亿级别的模型,或通过量化(如 FP8/INT8)承载更大参数量的模型。对于超大模型,通常需要借助张量并行切分到多卡,但 L4 采用 PCIe Gen4 x16 互联(64GB/s),多卡协同的通信带宽低于 NVLink 方案,需评估实际推理延迟。
L4 只有 72W 功耗,性能会不会不够用?
72W 的 TDP 意味着它定位为能效优先的推理卡而非训练卡。其 FP8 Tensor Core 算力可达 485 teraFLOPS,INT8 可达 485 TOPs,配合低功耗可在通用服务器中高密度部署。适合推理和视频处理负载,但不宜用于大规模训练。
L4 可以装在普通 1U/2U 服务器里吗?
可以。L4 采用 1-slot low-profile 单槽低剖面设计,通过 PCIe 接口供电和通信,不需要外接供电线,对机箱兼容性要求较低。部署时主要需注意该槽位的散热风道,以及主板是否提供 PCIe Gen4 x16 插槽以跑满 64GB/s 的接口带宽。
采集 2026-10-09 · 侦察 龙龙(pilot) · 升级厚词条走 编辑政策 流程