NVIDIA L4
概述OVERVIEW
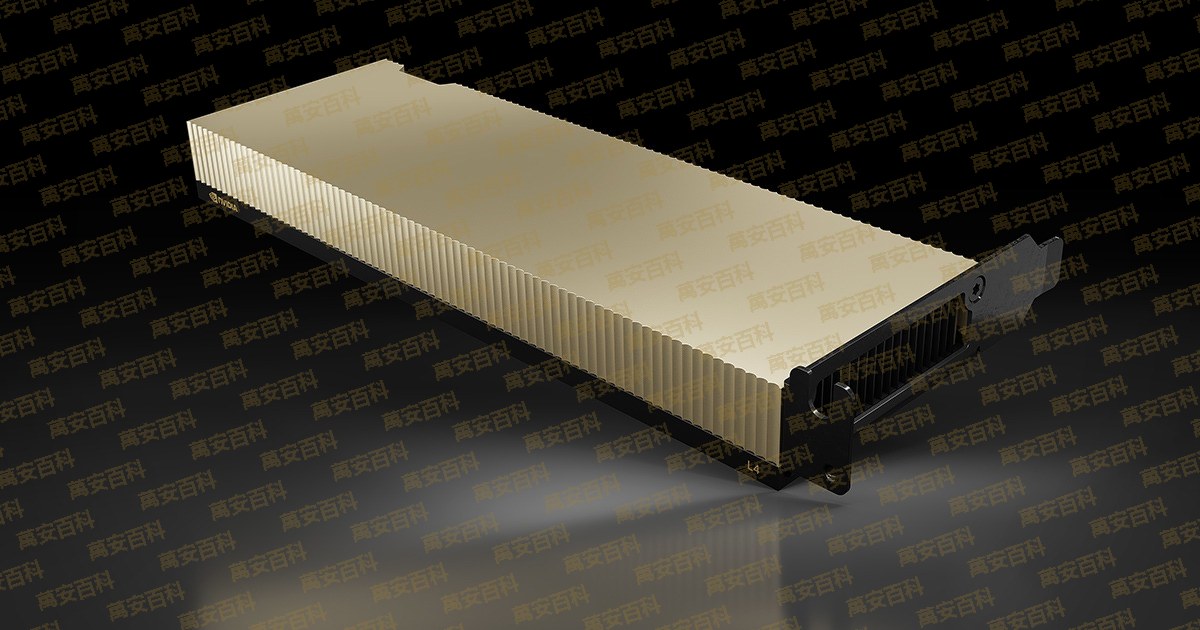
NVIDIA L4 是 NVIDIA 数据中心 GPU 里的「每瓦性能」特化型选手:Ada Lovelace 架构(官方页示 DLSS 3 与光线追踪支持的世代口径[1])、24GB GDDR6、72W 功耗、半高单槽形态——2022 年 3 月 GTC 随 H100 世代发布(公开报道口径[3]),官方定位是「视频+AI+图形」的通用低功耗加速:视频管线(官方称 1,040 路并发 720p30 AV1 流[1])、生成式 AI 推理、VDI 虚拟工作站三线开花。
它的账很简单:INT8 Tensor Core 485 TOPS(含稀疏口径;密集 242.5)、FP8 同级、FP32 30.3 TFLOPS——绝对算力不算旗舰,但 72W 无需外接供电、单槽半高可 1U 密铺,让它在「电费与机架空间是成本大头」的视频转码与推理场景里把 TCO 打成王牌[1]。2× NVENC + 4× NVDEC + 4× JPEG 解码器的媒体引擎配置是全家族最密的单卡。
定位边界也必须先讲:24GB 显存与 300GB/s 带宽决定了它不是大模型训练卡;PCIe Gen4 主机接口、30.3 TFLOPS 的 FP32 也都不是旗舰规格——L4 的性价比只在「视频/推理/视觉」三场景成立,采购前先对场景,再对价格。
适用场景FIT
萬安指数(0–100):本库按公开规格加权估算——显存 40% + 互联 30% + 生态 30%,按场景调权。90+ 旗舰级 · 75+ 优秀 · 60+ 可用 · 60 以下不适用。方法透明可复核,不构成性能承诺。
沿革HISTORY
2022 年 3 月,GTC 大会发布 L4:与 H100 同世代亮相,定位「视频+AI+图形」通用低功耗加速(公开报道口径[3])。
2022 年下半年,华硕/丽台等 OEM 卡陆续上市,以 OEM 服务器整机形态为主流入市(公开报道口径[4])。
2023 年,Google Cloud 推出 G2 实例(L4 供给)——首个主流公有云大范围供给 L4(公开报道口径[5])。
2024–2025 年,AV1 编码普及与生成式 AI 推理放量双轮驱动:视频管线(转码/审核/字幕)与中小模型推理成为公有云「性价比档」主力配置(公开报道口径[3])。
2026 年,官方页持续供货,1–8 卡 NVIDIA-Certified 服务器与伙伴系统在列(2026-10 核验[1])。
技术规格SPECIFICATIONS
| 项目 | 规格(NVIDIA L4 · 官方口径,2026-10 核验[1]) |
|---|---|
| GPU 架构 | Ada Lovelace 世代(官方页示 DLSS 3/光线追踪支持口径[1]) |
| 显存 | 24GB GDDR6 |
| 显存带宽 | 300GB/s |
| INT8 Tensor Core | 485 TOPS(含稀疏;密集 242.5,官方口径[1]) |
| FP8 Tensor Core | 485 TFLOPS(含稀疏口径,官方[1]) |
| FP16/BF16 Tensor Core | 242 TFLOPS(含稀疏;密集 121 级,官方口径[1]) |
| FP32 | 30.3 TFLOPS(官方口径[1]) |
| 媒体引擎 | NVENC ×2 | NVDEC ×4 | JPEG 解码 ×4(官方口径[1]) |
| 视频能力 | 官方称 1,040 路并发 720p30 AV1 流(官方口径[1]) |
| 功耗 | 72W(官方称「72W 低功耗包络」[1])——无需外接供电 |
| 形态 | 半高单槽 · 低剖面 · PCIe |
| 主机接口 | PCIe Gen4 x16 · 64GB/s(官方口径[1]) |
| 服务器配置 | 伙伴/NVIDIA-Certified 系统 1–8 卡(官方口径[1]) |
规格以 NVIDIA L4 官方页为准(2026-10 核验[1]);稀疏/密集口径按官方页「with sparsity」标注转写;CUDA 核心数官方页未列明,采购前以 nvidia-smi 实测核验。
选型对照 · L4 vs T4 vs L40SCONTEXT
| 项目 | NVIDIA T4(上代) | NVIDIA L4 | NVIDIA L40S |
|---|---|---|---|
| 显存 | 16GB GDDR6 | 24GB GDDR6 | 48GB GDDR6 |
| 显存带宽 | 320GB/s | 300GB/s | 864GB/s |
| INT8 | 130 TOPS 级(世代口径) | 485 TOPS(含稀疏[1]) | 725 TOPS 级(含稀疏,见本站词条) |
| 媒体引擎 | NVENC ×1 | NVDEC ×2 | NVENC ×2 | NVDEC ×4 | JPEG ×4[1] | NVENC ×3 | NVDEC ×3 |
| 功耗 | 70W | 72W | 350W |
| 形态 | 半高单槽 | 半高单槽 | 全高双槽 |
| 选型一句话 | 存量基线 | 视频/推理性价比档 | 大显存推理档 |
对照为官方各产品页口径与本站词条数据;T4 为 Turing 世代基线供换算参考。媒体引擎与编码格式支持以 NVENC/NVDEC 支持矩阵[6]为准。
家族成员FAMILY
Ada Lovelace 数据中心家族谱系:
散热与部署COOLING
L4 的部署画像:72W 无外接供电(PCIe 插槽供电即可)+ 半高单槽 + 被动散热——1U 服务器可密铺多卡,功耗密度是它对 350W 级 L40S 的核心部署优势(官方形态口径[1])。被动散热意味着机箱风道是硬前置:塔式工作站/改造机箱装 L4 必须确认正式风道,否则过热降频。
PCIe Gen4 主机接口——配 Gen5 主板带宽仍按 Gen4 跑(64GB/s,官方口径[1]);采购时主机代际与卡匹配即可,不必为它上 Gen5 整机。
模型适配MODEL FIT
| 场景 | 单卡 24GB 的适配口径(推算:权重×精度+KV/框架开销,方法详见选型器) |
|---|---|
| 7B–14B 推理 | FP16 权重 14–28GB 级:7B FP16/14B FP8 单卡常驻为舒适区(推算口径) |
| 70B 级 4-bit 量化 | 权重约 35GB 级——单卡不可及,双卡分片可跑(推算口径,吞吐让位于带宽) |
| 嵌入/RAG/重排 | embedding 与 reranker 模型普遍 <10GB 级:长驻低功耗量产位(推算口径) |
| 视觉/多模态 | 4× JPEG 硬解喂图流[1]:OCR/质检/内容审核管线的加速位 |
| 视频转码 | 1,040 路并发 720p30 AV1 官方口径[1]——FFmpeg NVENC 管线标准适配 |
| 不适用 | 大模型训练(300GB/s 带宽与 24GB 容量双重上限,官方口径[1]) |
口径:显存占用 ≈ 参数量 × 每参数字节数(FP16=2B / FP8=1B / INT4=0.5B),KV 与框架开销另计;与选型器「显存算账」同源可复核。
图集GALLERY
半高单槽形态与散热器细节参见 NVIDIA 官方页[1]与 OEM 厂商(华硕/丽台等)产品页。
视频讲解VIDEO
本词条视频讲解排产中(中文/多语言版本制作流程见视频窗排产单)——上线后本区块自动更新。
软件与生态ECOSYSTEM
CUDA 全栈+媒体双生态:推理侧 TensorRT-LLM/Triton Inference Server/vLLM 标准适配(FP8 走 Ada Tensor Core);媒体侧 FFmpeg NVENC/NVDEC 管线与 AV1 编码硬件原生支持(编码格式矩阵见官方文档[6]);云侧 GCP G2 等公有云实例将 L4 作为「性价比档」标准供给(公开报道口径[5])。
与消费卡(4090 级)的转码对比:数据中心卡无 NVENC 并发会话数限制(驱动政策口径),7×24 视频管线选 L4 而非消费卡是合规与稳定性的双重选择——这一条常被低价方案刻意略过。
采购与验货PROCUREMENT
常见风险
单卡流通建议第三方验货或平台验货验资流程——大厅检索 ›
如何压测BENCH TEST
判例工具:nvidia-smi/DCGM(功耗/温度/ ECC 状态)、bandwidthTest(显存带宽对照 300GB/s 官方标称[1])、gpu-burn(烤机,72W 包络验证)、FFmpeg 基准(目标格式转码实测路数对照 1,040 路 720p30 AV1 官方口径[1])、TRT-LLM/vLLM 基准(自有模型推理吞吐与延迟)。转码卡的验收核心是「实测路数+长期不降频」双指标。本卡专属判例片排产中。
运输与交付LOGISTICS
| 环节 | 要点 |
|---|---|
| 形态与重量 | 半高半长小体积单卡——防静电袋+防静电棉即可,整箱运输抗震要求低 |
| 散热器 | 被动散热无风扇——运输忌散热鳍片挤压变形,到货先查外观 |
| 跨境合规 | 消费级以下算力档位,跨境管制敏感度低于旗舰卡——仍以当期清单与海关口径为准 |
| 保险 | 按货值投保;整机形态交付以服务器整体验收为准 |
OEM 与变体VARIANTS
| 变体 / OEM | 形态与定位 |
|---|---|
| NVIDIA L4 | 半高单槽标准形态(官方口径[1]) |
| OEM 卡 | 华硕/丽台/技嘉等合作形态(公开报道口径[4]) |
| NVIDIA-Certified 服务器 | 1–8 卡系统集成(官方口径[1]) |
| 云实例 | GCP G2 等公有云 L4 实例(公开报道口径[5]) |
局限与争议LIMITS
- 24GB/300GB/s 上限:显存与带宽双低配(官方口径[1])——训练与大模型场景直接出局,70B 级量化推理也要双卡分片。
- PCIe Gen4 而非 Gen5:64GB/s 主机带宽(官方口径[1])——数据吞吐敏感的推理服务在 Gen5 平台上得不到带宽红利。
- FP32 仅 30.3 TFLOPS:图形/仿真性能一般(官方口径[1])——它是「视频+AI」特化卡,不是全能卡。
- 零售流通少:渠道以整机形态为主(官方 1–8 卡系统口径[1])——散卡市场小且拆机件风险高。
- 72W 性能天花板:每瓦性能的代价是绝对性能——高吞吐转码 farm 需要按路数堆卡,单卡性能不能与 L40S 同日而语。
行情说明MARKET
| 日期 | 类型 | 市场 | 价格带 | 口径 |
|---|---|---|---|---|
| 2026-10 | 卡价 | 海外渠道 | 无官方常驻卡价 · 以渠道报价为准(OEM 整机形态为主[1]) | 渠道口径 |
| 2026-10 | 云租金 | 海外公有云 | 按 GPU·时计费(GCP G2 等实例[5],以云商价目页为准,随区域浮动) | 第三方口径 |
| 2026-10 | 大厅状态 | 中国大陆 | 散卡流通少 · 整机/拆机件为主 | 大厅检索 › |
口径:本库无该型号常驻成交数据;「以渠道报价为准」即本库不采信单方要价为锚。行情与货盘:萬安算交所(0 佣金撮合、不参与交易)。
大事记MILESTONES
| 时间 | 事件 |
|---|---|
| 2022-03 | GTC 发布 L4(与 H100 世代同台,公开报道口径[3]) |
| 2022 下半年 | OEM 卡与服务器系统陆续上市(公开报道口径[4]) |
| 2023 年 | Google Cloud G2 实例上线——首个主流云大范围供给(公开报道口径[5]) |
| 2024–2025 | AV1 普及+生成式 AI 推理放量:视频管线与「性价比档」推理双主力(公开报道口径[3]) |
| 2026-10 | 官方页供货中:1–8 卡认证系统在列(2026-10 核验[1]) |
常见问题FAQ
相关词条SEE ALSO
参考资料REFERENCES
| [1] | NVIDIA 官方 · L4 产品页(24GB/300GB/s/485 TOPS 含稀疏/72W/半高单槽/Gen4/NVENC2+NVDEC4+JPEG4/1,040 路 AV1 口径) · https://www.nvidia.com/en-us/data-center/l4/(2026-10 核验) |
| [2] | NVIDIA 官方 · NVENC/NVDEC 编码格式支持矩阵 · https://developer.nvidia.com/video-codec-support(官方文档) |
| [3] | 公开报道 · GTC 2022 L4 发布与视频/AI 放量动态 · https://www.reuters.com/technology/(公开报道口径) |
| [4] | 公开报道 · OEM 卡与服务器形态上市动态(华硕/丽台等) · https://www.reuters.com/technology/(公开报道口径) |
| [5] | Google Cloud · GPU 文档(G2 实例 L4 供给) · https://cloud.google.com/compute/docs/gpus(第三方口径) |
| [6] | 本站 · L40S 词条(家族对照数据源) · /wiki/l40s.html(本站词条) |
| [7] | 选型器 · 显存算账口径(参数量 × 精度 + KV/框架开销) · /wiki/xuanxing.html(本站口径) |
规格以 NVIDIA 官方页为锚;「公开报道口径」类条目为媒体转述,本库不背书其真实性;转码路数等官方口径为实验室条件,业务实测为准。