规格词条 · 中卡 STANDARD CARD
NVIDIA H100 NVL
单卡94GB HBM3、双卡NVLink桥接188GB,70B级LLM推理专用卡,350-400W风冷双槽好托管,AI Enterprise随卡附赠,二手市场绕不开的准旗舰
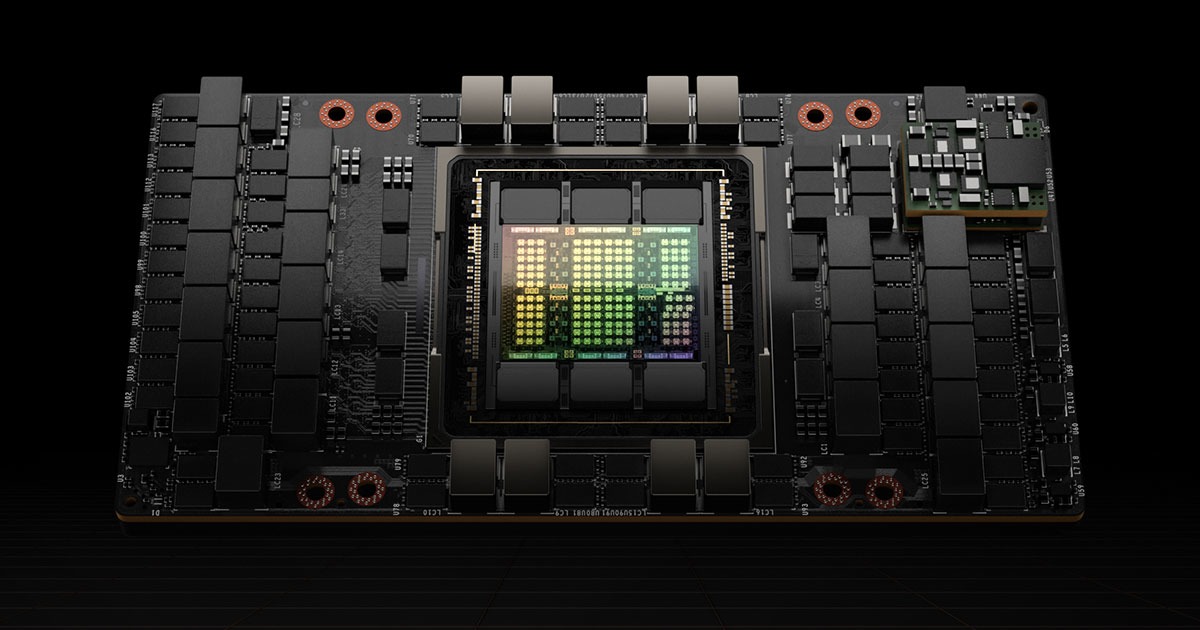
NVIDIA 厂商官方图
概述
NVIDIA H100 NVL是NVIDIA基于Hopper架构推出的PCIe形态数据中心GPU,定位为大显存推理场景的准旗舰产品。单卡配备94GB HBM3显存,通过NVLink桥接可将两张卡组合为188GB的统一显存池,适合承载大参数量语言模型的推理负载。该卡采用双槽风冷设计,TDP可在一定范围内配置,便于在标准机架环境中部署;卡间通过NVLink提供双向600GB/s互联带宽,同时支持PCIe Gen5主机接口。随卡附带NVIDIA AI Enterprise软件套件,覆盖企业级AI推理与部署需求。
核心规格
| 架构 | NVIDIA Hopper |
| 显存 | 94GB |
| 显存类型 | HBM3 |
| 显存带宽 | 3.9TB/s |
| FP64算力 | 30 teraFLOPs |
| FP64 Tensor Core | 60 teraFLOPs |
| FP32算力 | 60 teraFLOPs |
| FP8算力 | 3,341 teraFLOPS |
| FP16算力 | 1,671 teraFLOPS |
| INT8算力 | 3,341 TOPS |
| 功耗TDP | 350-400W (configurable) |
| 互联 | NVIDIA NVLink: 600GB/s | PCIe Gen5: 128GB/s |
| 形态 | PCIe dual-slot air-cooled |
| MIG切片 | Up to 7 MIGS @ 12GB each |
| 编解码器 | 7 NVDEC | 7 JPEG |
规格已与官方基准快照对账(基准来源,采集 2026-10-09)· 价格以货主实际报价为准
适用场景
- 大参数量语言模型(LLM)推理服务,双卡NVLink桥接后188GB显存可容纳完整模型权重并留出KV Cache空间
- 多租户GPU资源切分:利用MIG技术将单卡划分为多至7个实例,每个实例12GB显存,适合推理小模型或隔离多个业务
- 视频与图像处理流水线:内置多路NVDEC解码器与JPEG解码单元,适合推理与解码混合的视觉AI负载
- 企业级AI平台部署:依托附带的NVIDIA AI Enterprise获得受支持的企业软件栈,用于生产环境的推理与微调任务
同族型号
| 型号 | 显存 | 功耗 |
|---|---|---|
| NVIDIA A30 对比 | 24 GB HBM2 | 165 W |
| NVIDIA L40 对比 | 48 GB GDDR6 with ECC | 300W |
| NVIDIA H200 NVL 对比 | 141GB | Up to 600W (configurable) |
| NVIDIA H800 对比 | 80 GB HBM2e | 350 W |
| NVIDIA A2 对比 | 16 GB GDDR6 | 40–60W (configurable) |
| NVIDIA A16 对比 | 4x 16GB GDDR6 | 250W |
深度阅读:H100 · 厚词条
采购与验货要点
- 确认机箱与电源兼容性:H100 NVL为PCIe双槽风冷形态,TDP可在一定范围内配置,采购前需核实服务器槽位高度、风道设计与单卡供电余量,风冷方案对机房散热与噪音管理的要求低于液冷SXM方案,但满载时仍需保证充足前进风量
- 验证NVLink桥接配置:若采购目标是双卡188GB大显存推理,需确认随卡或配套的NVLink桥接器是否齐全,以及主板卡间距是否满足桥接器安装条件;单卡使用时桥接器可以省略
- 二手与库存渠道验货要点:核对显存容量(单卡94GB HBM3)与设备序列号,测试NVLink与PCIe Gen5链路协商状态,确认MIG分区功能正常,并确认NVIDIA AI Enterprise授权的随卡交付方式与剩余支持期限
常见问题
H100 NVL和普通PCIe版H100有什么区别?
H100 NVL是PCIe形态的H100变体,主要差异在于配备了NVLink桥接能力,可将两张卡桥接为188GB的联合显存池,专为需要跨卡大显存的推理场景设计;而标准PCIe版通常不带出厂桥接方案。两者均基于Hopper架构。
单卡94GB够跑大模型吗?什么时候需要双卡桥接?
这取决于模型参数量与量化方案。若单卡显存不足以容纳模型权重加上KV Cache等运行时开销,可以通过NVLink桥接两张H100 NVL获得188GB联合显存。桥接后显存池由NVLink以600GB/s带宽连接,通信效率高于走PCIe Gen5的多卡方案。
H100 NVL适合出租或托管吗?MIG有什么用?
适合。该卡采用标准PCIe双槽风冷设计,可配置的TDP使其能够部署在常规机架服务器中,托管门槛相对较低。MIG功能可将单卡物理切分为多至7个独立实例,每个实例12GB显存,彼此隔离,适合云服务商或团队将一张卡分给多个租户或多个轻量推理任务使用。
采集 2026-10-09 · 侦察 侦察兵-自动小弟B2 · 升级厚词条走 编辑政策 流程