SECTIONS
EDITIONS
NETWORK
萬安百科 › 机型词条 › NVIDIA Tesla P40
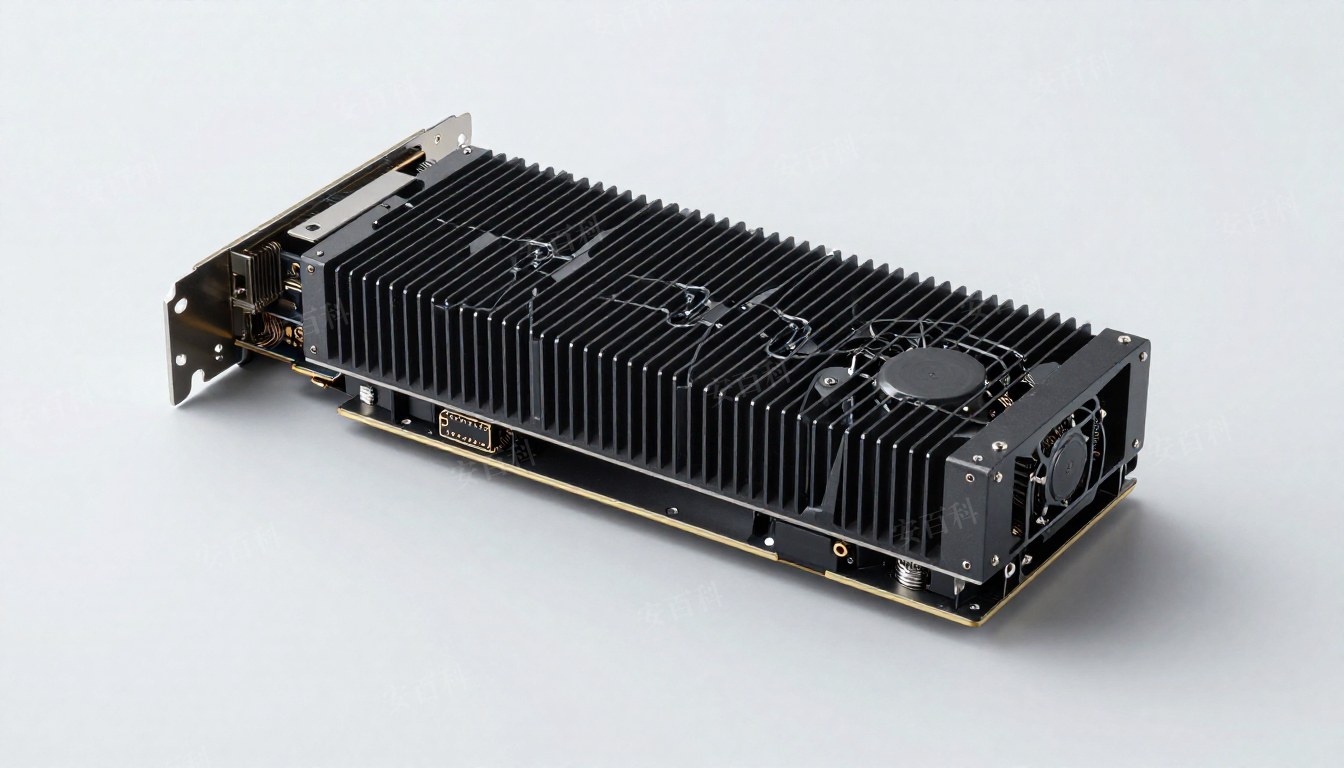
示意配图(AI 生成·非官方产品图)· 萬安百科
NVIDIA Tesla P40
Pascal 推理卡 · 3840 CUDA · 24GB GDDR5 · INT8 47 TOPS · 流通主力词条
概述OVERVIEW
Tesla P40 是 NVIDIA Pascal 世代的推理专用数据中心卡(2016-09 发布,官方产品简报口径, 2026-11 核验):3840 CUDA 核(GP102)、24GB GDDR5 · 384bit · 346GB/s、INT8 47 TOPS、 FP32 约 12 TFLOPS、250W 被动散热(无显示输出·服务器专用形态)、vGPU 支持 24 实例(官方口径)。 AI 语境定位:24GB 大显存推理的普及档——单卡可容 7B–14B 级量化模型(推算口径),流通保有量大, 是预算敏感型推理部署的常见选择。
沿革HISTORY
- 2016-09:Pascal 世代数据中心线发布(P40 推理/P100 计算双线,官方口径)。
- 2017-2020:推理服务器大规模装机(vGPU/视频转写/图像推理场景,官方场景口径)。
- 2023 起:大模型时代 24GB 大显存价值重估——量化推理部署常用卡(社区/媒体口径)。
- 现役:流通市场保有主力之一(Pascal 世代代际差如实写——见局限节)。
推理卡演进对照GENERATIONS
| 维度 | Tesla P40(本词条·官方口径) | Tesla V100(词条) | Tesla T4(对照) |
|---|---|---|---|
| 架构/年代 | Pascal · 2016-09 | Volta · 2017-12 | Turing · 2018-09 |
| 显存 | 24GB GDDR5 · 346GB/s | 16/32GB HBM2 · 900GB/s | 16GB GDDR6 · 300GB/s |
| AI 算力 | INT8 47 TOPS(官方) | Tensor 125 TFLOPS | INT8 130 TOPS |
| 功耗/散热 | 250W · 被动 | 250W(PCIe) · 被动 | 70W · 被动 |
| 定位 | 大显存推理普及档 | 训练/推理双能旗舰 | 低功耗推理档 |
口径:P40 列=NVIDIA 官方产品简报(2026-11 核验);V100/T4 列=各自官方规格书口径。Pascal 无 Tensor Core/FP16 弱为架构事实——代际差如实写,采购按推理负载实测。
技术规格SPECS
| 项目 | 规格(NVIDIA 官方产品简报口径) |
|---|---|
| 架构 | Pascal · GP102 |
| CUDA | 3840 核 · FP32 约 12 TFLOPS |
| AI 算力 | INT8 47 TOPS(官方口径·推理主档) |
| 显存 | 24GB GDDR5 · 384bit · 346GB/s |
| 功耗/形态 | 250W · 被动散热 · 双槽全高全长 · 无显示输出 |
| 总线 | PCIe 3.0 x16 · 无 NVLink |
| 虚拟化 | vGPU 支持 · 最高 24 实例 · 24 路 H.264 1080p30(官方口径) |
| AI 栈 | CUDA 全生态(TensorRT INT8 量化推理·生态口径) |
模型适配MODEL FIT
| 场景 | 24GB 显存的适配口径(推算:权重×精度+开销) |
|---|---|
| 7B–14B 级 | INT8/4-bit 量化推理可容——预算敏感部署的常见档(推算口径) |
| 多卡堆叠 | 被动散热+PCIe 3.0——机架堆卡跑独立推理实例(非并行训练) |
| 训练场景 | 不定位此场景——无 Tensor Core/FP16 弱/无 NVLink(架构边界如实) |
24GB 档云端平替——去模型广场按需调用
萬安云 · 模型广场 →局限与边界LIMITS
- 架构代际:Pascal 无 Tensor Core、FP16 吞吐弱、PCIe 3.0/无 NVLink——吞吐能效对现代卡差数代(官方规格对照),采购按推理实测决策。
- 机房前提:250W 被动散热——机箱风道与机房空调是硬前提(官方安装口径)。
- 验货要点:散热器完整性+显存压测+供电核算——流通卡逐项走 验货流程。
常见问题FAQ
P40 为什么在 AI 推理里这么常见?
三件:①24GB 大显存(2016 年即给到,单卡可容 7B–14B 级量化模型,推算口径)②被动散热机架形态适合堆机器 ③流通保有量大——INT8 47 TOPS(官方口径)跑量化推理仍是可用档。
P40 的短板是什么?
架构代际如实写:Pascal 无 Tensor Core、FP16 弱(走 FP32/INT8)——吞吐与能效对现代卡差数代;无 NVLink、PCIe 3.0——单卡推理可用,训练/多卡协同不合适。
验 P40 看什么?
被动散热卡通检:散热器完整(鳍片无塌陷堵塞)+ 风道机房前提 + 显存压测 + 供电 250W 核算;无显示输出是正常形态(不是坏),按 <a href='/wiki/how-to-buy-verified-gpu.html'>验货流程</a> 逐项。
相关词条SEE ALSO
NVIDIA Tesla V100(Volta 旗舰)
NVIDIA RTX 3090(24GB 消费档)
NVIDIA RTX 4090(24GB 现役档)
NVIDIA L4(低功耗推理档)
CUDA(生态词条)
如何买卖验证过的 GPU