光模块与线缆
概述OVERVIEW
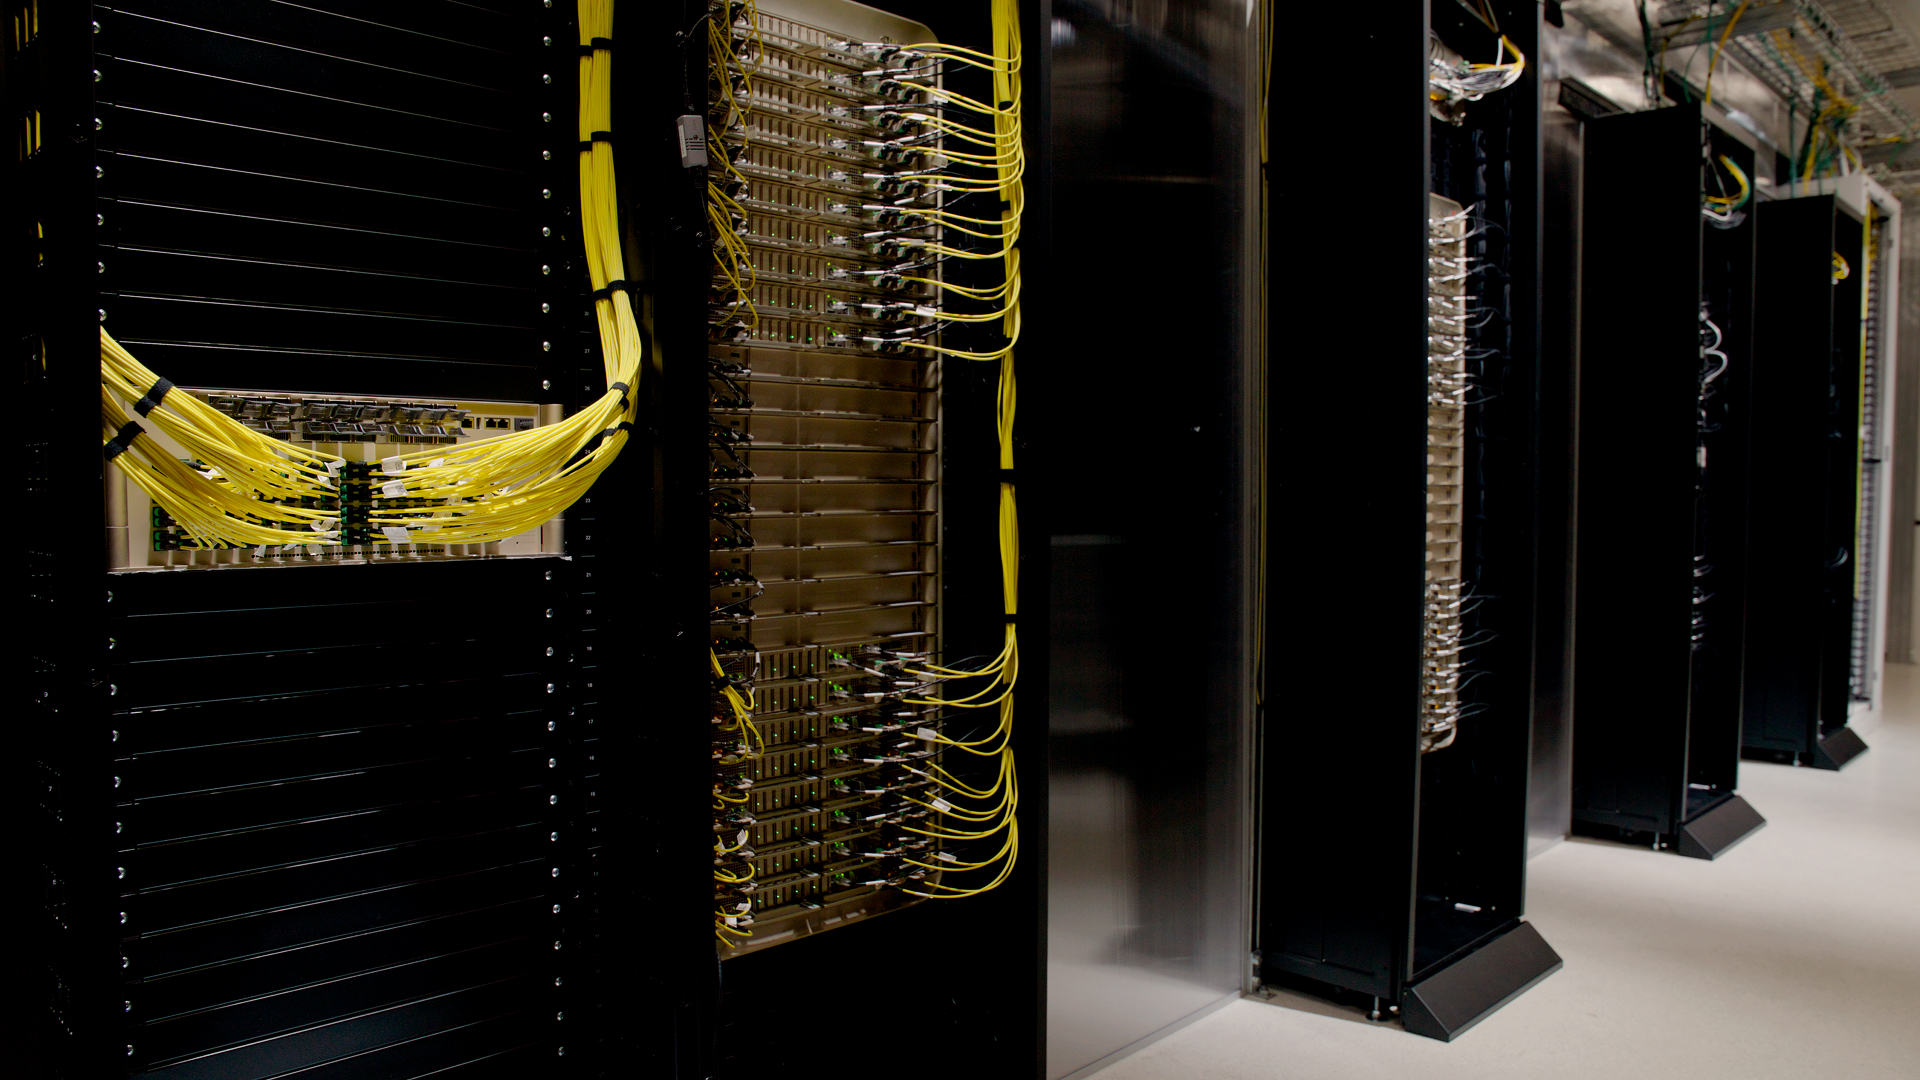
光模块与线缆是 AI 机房的第二大采购件——GPU 之外,把算力连成集群的互连层(NVIDIA 官方互连产品线 LinkX 的口径)按距离分三路:DAC 铜缆(≤3m 机柜内,无源零功耗)、AOC 有源光缆(2.5-5m 柜间)、光模块(DR 500m/FR 2km 跨机房——LinkX 官方距离矩阵口径[3])。
AI 集群把它推成了千亿级赛道:NVL72 一柜的柜内铜缆约 5000 根(Scale-up 铜互连口径[5]),跨柜的每 GPU 光口速率按 200G→400G→800G 代际翻番(官方代际口径[5]);国产厂商在全球光模块供应的头部地位由营收数据支撑——头部三家的季度营收量级已达十亿美元级(公开财报口径[6])。
本词条是品类选型词条:讲三路互连的选型逻辑、规格档位与厂商格局。互连件无统一行情,价格以货主实际报价为准。
适用场景FIT
萬安指数(0–100):按互连场景匹配度加权(品类特化口径)。
沿革HISTORY
2023-2024 年,AI 需求引爆互连层:H100 集群的大规模部署把 400G 光模块需求推高,800G 随 H200/Blackwell 世代起量——光模块从电信周期切换到 AI 周期(行业口径[6])。
2024 年 3 月,NVIDIA GTC 发布 X800 世代:Quantum-X800/Spectrum-X800 交换平台配套 800G 互连——LinkX 产品线的距离矩阵(DAC 3m/LACC/AOC/DR 500m/FR 2km)成为 AI 机房布线的官方参照(官方产品线口径[3])。
2025 年,国产头部营收兑现:中际旭创、新易盛等国产光模块厂商的 AI 相关营收高速增长(公开财报口径:头部厂商季度营收达十亿美元级[6])——全球光模块供应的头部格局由中国厂商领衔(财报口径支撑,份额百分比未核验不写)。
2025-2026 年,CPO 元年:NVIDIA 发布共封装光学(CPO)交换机——144×800G/409.6Tb/s、官方口径能效 5×(官方产品页口径[5]);Marvell 32.5 亿美元收购 Celestial AI 进军 CPO(公开报道口径[6])——光互连的技术路线竞争进入新阶段。
规格档位SPEC TIERS
| 档位 | 距离 / 规格 | 场景 | 口径 |
|---|---|---|---|
| DAC 铜缆 | ≤3m(无源) | 机柜内 GPU↔交换机 | LinkX 官方矩阵[3] |
| LACC 有源铜缆 | 2.5-5m · 约 4W | 近距柜间 | LinkX 官方矩阵[3] |
| 800G DR4 光模块 | 500m · 18W max(2W 低功耗档)· CMIS 4.0 · MPO-12 APC | 跨柜/机房内 fabric | NVIDIA MMS4A20 文档口径[3] |
| FR 光模块 | 2km | 跨机房 | LinkX 官方矩阵[3] |
| 800G ZR+ 相干 | 500-1000km@800G · 400G@2500km | DCI 数据中心互连 | Marvell 公开产品口径[6] |
| CPO 交换 | NVIDIA Q3450-LD:144×800G · 409.6Tb/s | 下一代机房能效路线 | NVIDIA CPO 官方页[5] |
档位为 NVIDIA 官方产品线与公开厂商资料的整理(2026-10 口径[2][4][5];具体兼容列表以交换机厂商官方文档为准。
厂商格局VENDORS
光模块与互连件的供应格局(公开财报与实测报道口径[3][5];本库不构成采购推荐):
| 阵营 | 代表 | 定位 |
|---|---|---|
| NVIDIA 自有 | LinkX 线缆与模块产品线 | 与自家交换机/GPU 生态绑定,距离矩阵官方背书[3] |
| 国产头部 | 中际旭创 / 新易盛 | 公开财报口径:季度营收达十亿美元级、AI 相关高速增长(2026 Q1 口径[6])——全球供应头部地位由营收支撑 |
| 国际厂商 | Coherent / Lumentum / Marvell | Coherent 高速增长、Lumentum 季度营收 $808M 量级、Marvell 32.5 亿美元收购 Celestial AI 进军 CPO(公开报道口径[6]) |
| 国内梯队 | 光迅科技 / CIG 等 | 800G 放量梯队(公开报道口径[6]) |
厂商信息来自公开财报与 LightCounting 行业口径[5];份额百分比未经原文核验不写,是本库纪律。
图集GALLERY
部署与配套DEPLOYMENT
互连件的部署纪律:按距离选三路(机柜内 DAC/近距 AOC/长距光模块——LinkX 矩阵口径[3])、兼容列表核对(交换机与网卡厂商的模块兼容清单逐个对——第三方模块的兼容性与质保是常见坑)、功耗预算(800G 光模块单只 18W 级口径[3]——一柜几百只的累计功耗要进机柜散热账)。
CPO 路线的运维提示:共封装光学把光引擎搬进交换机封装——模块级热插拔的传统运维模式改变,故障域与备件策略随之调整(本库整理口径)。
采购与验收PROCUREMENT
互连件采购的验收要点(三项):
术语卡GLOSSARY
DAC 铜缆
Direct Attach Copper 无源铜缆:≤3m 矩离、零功耗、成本最低——机柜内 GPU↔交换机的默认互连(NVL72 柜内约 5000 根铜缆口径[5])。
AOC 有源光缆
Active Optical Cable:两端带光收发的定制长度光缆——2.5-5m+ 的柜间互连档(LinkX 矩阵口径[3]),比 DAC 传得远、比光模块方案省心。
DR4 / FR
光模块的距离规格代号:DR=500m(单模 4 并联)、FR=2km(单模单波)——800G DR4 单只 18W max、CMIS 4.0 管理(NVIDIA 文档口径[3])。
CPO 共封装光学
Co-Packaged Optics:光引擎与交换芯片共封装——NVIDIA 官方口径 144×800G/409.6Tb/s/能效 5×(产品页口径[5]),下一代机房的能效路线。
GPUDirect RDMA
存储/网络数据直达 GPU 显存的通路(绕过 CPU)——互连件(网卡+模块+线缆)的质量直接决定这条通路的误码与吞吐表现。
局限与争议LIMITS
- 兼容性是最大的坑:第三方模块与交换机的兼容列表差异、固件握手失败——「插得上」不等于「跑得稳」,兼容列表核对与批量误码抽测是底线(本库整理口径)。
- 代际迭代快:200G→400G→800G→1.6T 的节奏下,模块资产贬值快——采购批量与代际切换节奏对表(本库整理口径)。
- 功耗账容易漏:800G 光模块单只 18W 级(文档口径[3])——几百只的累计功耗与散热要进机柜账,CPO 是能效解法但生态尚早期(官方口径[5])。
- 市占与份额数据纪律:行业份额报告常被二手转述失真——本页厂商格局以财报营收为支撑、份额百分比未核验不写(本库纪律,同整体口径)。
- 本词条为品类视角:交换机与网卡详见各自词条(QM9700/SN5600/CX-7/BlueField-3);本页聚焦互连件品类。
行情说明MARKET NOTE
价格节点大事记MILESTONES
常见问题FAQ
按距离:机柜内 ≤3m 用 DAC(零功耗最便宜)、柜间 2.5-5m 用 AOC、跨机房 500m+ 用光模块(DR/FR 档)——LinkX 官方矩阵是参照系,混用会浪费预算或传不过去。
量级参考:800G DR4 单只 18W max(另有 2W 低功耗档,NVIDIA 文档口径)——一柜几百只的累计功耗要进机柜散热账;CPO 路线的能效优势(官方口径 5×)就是冲这个来的。
看兼容列表:交换机/网卡厂商的官方兼容清单逐个核对——物理可插不等于链路稳定,第三方模块的固件握手与质保是常见坑;批量采购前批量误码抽测。
黄仁勋公开讲稿口径:1-2 米内铜互连高可靠、高能效、低成本——柜内 NVLink 域用铜缆背板(约 5000 根),跨柜才上光——「铜做 scale-up、光做 scale-out」是 NVIDIA 的公开技术路线。
共封装光学:光引擎与交换芯片封装在一起(NVIDIA 官方口径 144×800G/409.6Tb/s/能效 5×)——技术路线确定但生态早期,普通采购者关注即可,超大规模机房是首批用户。
相关词条SEE ALSO
选型对照与延伸EXPLORE
参考资料REFERENCES
- NVIDIA 官网 — LinkX 互连产品线(距离矩阵与产品口径,2026-10) https://www.nvidia.com/en-us/networking/interconnect/
- NVIDIA 官方文档 — MMS4A20:800G DR4 光模块规格(500m/18W/CMIS 4.0) https://networking-docs.nvidia.com/
- NVIDIA 官网 — 共封装光学(CPO)交换机产品页(144×800G/409.6Tb/s 口径) https://www.nvidia.com/en-us/networking/interconnect/
- ServeTheHome — NVL72 铜互连与集群实测报道(Scale-up 口径) https://www.servethehome.com/
- LightCounting — 光模块行业公开口径(营收与增长数据,2026) https://www.lightcounting.com/
- 在售检索 — 萬安算交所(0 佣金撮合;互连件暂无行情快照,价格以货主报价为准) https://www.aixx.vip/hall.html