规格词条 · 中卡 STANDARD CARD
NVIDIA H200 NVL
141GB HBM3e+4.8TB/s单卡装下700亿参数全量,2/4路NVLink桥接900GB/s,600W内风冷可托管,大显存推理卡里的现货新贵
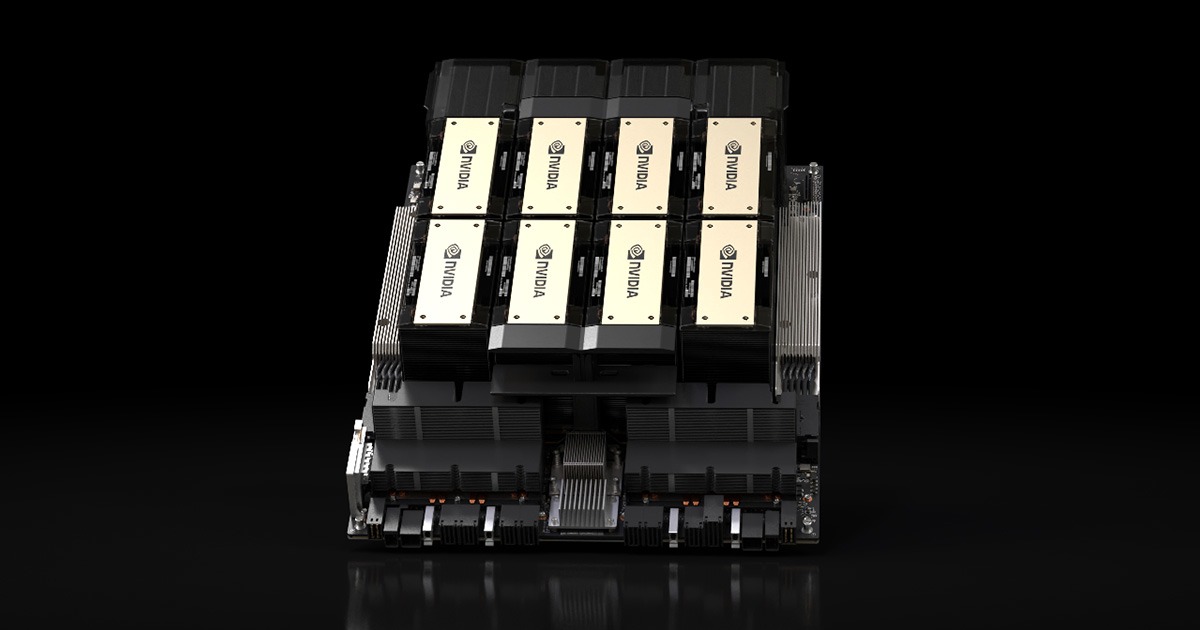
NVIDIA 厂商官方图
概述
NVIDIA H200 NVL是NVIDIA基于Hopper架构打造的数据中心GPU,采用PCIe双槽风冷形态,面向大显存推理与训练场景。其单卡搭载141GB HBM3e显存,是官方页面对外强调的核心特性,可在大容量模型场景下减少多卡拆分带来的复杂度。卡间可通过2路或4路NVLink桥接实现每GPU 900GB/s的互联带宽,也可走PCIe Gen5(128GB/s)与主机通信。该卡支持多实例GPU划分(最多7个实例,每个16.5GB)与机密计算,并附带NVIDIA AI Enterprise软件支持,典型用途包括大语言模型推理、多模态模型部署及视频解码类工作负载。
核心规格
| 架构 | NVIDIA Hopper |
| 显存 | 141GB |
| 显存类型 | HBM3e |
| 显存带宽 | 4.8TB/s |
| FP64算力 | 30 TFLOPS |
| FP64 Tensor Core | 60 TFLOPS |
| FP32算力 | 60 TFLOPS |
| FP8算力 | 3,341 TFLOPS |
| FP16算力 | 1,671 TFLOPS |
| INT8算力 | 3,341 TFLOPS |
| 功耗TDP | Up to 600W (configurable) |
| 互联 | 2- or 4-way NVIDIA NVLink bridge: 900GB/s per GPU | PCIe Gen5: 128GB/s |
| 形态 | PCIe Dual-slot air-cooled |
| MIG切片 | Up to 7 MIGs @16.5GB each |
| 编解码器 | 7 NVDEC | 7 JPEG |
| 机密计算 | Supported |
规格已与官方基准快照对账(基准来源,采集 2026-10-09)· 价格以货主实际报价为准
适用场景
- 大语言模型推理服务:141GB HBM3e显存可在单卡或少量卡内承载较大参数量的模型全量权重,降低多卡切分与跨卡通信开销
- 多卡推理与中小规模训练:通过2路或4路NVLink桥接获得每GPU 900GB/s互联,适合需要卡间高速协同的部署形态
- 多租户GPU资源切分:借助多实例GPU能力,单卡最多可划分为7个独立实例(每个16.5GB显存),用于隔离多个轻量推理负载
- 视频与图像处理管线:内置7路NVDEC与7路JPEG解码单元,适合推理与媒体解码混合的边缘侧或机房侧工作负载
同族型号
| 型号 | 显存 | 功耗 |
|---|---|---|
| NVIDIA A30 对比 | 24 GB HBM2 | 165 W |
| NVIDIA L40 对比 | 48 GB GDDR6 with ECC | 300W |
| NVIDIA H800 对比 | 80 GB HBM2e | 350 W |
| NVIDIA H100 NVL 对比 | 94GB | 350-400W (configurable) |
| NVIDIA A2 对比 | 16 GB GDDR6 | 40–60W (configurable) |
| NVIDIA A16 对比 | 4x 16GB GDDR6 | 250W |
深度阅读:H200 · 厚词条
采购与验货要点
- 确认机房形态匹配:该型号为PCIe双槽风冷设计,部署前需核对服务器PCIe槽位间距、双槽散热空间与风冷散热能力,风冷托管条件下应评估机柜进风温度与风道,避免高密度部署时局部过热
- 确认互联方案:如需多卡协同,采购时需同步确认2路或4路NVLink桥接器的选型与主板兼容性;仅用PCIe Gen5时互联带宽为128GB/s,需评估是否满足目标模型的通信需求
- 核对配套与真伪:通过授权渠道采购并验证官方保修,确认附带NVIDIA AI Enterprise授权;同时确认TDP配置档与供电方案,该卡功耗可配置,上线前应按实际设定值核算机柜供电与PDU余量
常见问题
H200 NVL和H200 SXM有什么区别?
两者同属H200产品线、基于相同的Hopper架构,主要差异在形态与部署方式:H200 NVL为PCIe双槽风冷设计,便于在标准服务器中部署与后续扩容;H200 SXM为SXM模组形态,需搭配专用基板。互联方面,H200 NVL通过2路或4路NVLink桥接实现每GPU 900GB/s的卡间带宽,并可回退到PCIe Gen5(128GB/s)通信。
单卡141GB显存跑大模型还需要多卡吗?
取决于模型参数量、量化精度与并发批次大小。H200 NVL的141GB HBM3e显存可以在单卡内容纳较大规模模型的权重与KV缓存,减少张量并行带来的通信开销;若模型更大或需要更高吞吐,可通过2路或4路NVLink桥接扩展为多卡实例,卡间900GB/s的互联有助于降低多卡推理的延迟损失。建议以目标模型的实际显存占用测算后再决定卡数。
H200 NVL支持把一张卡分给多个用户或任务使用吗?
支持。该卡具备多实例GPU(MIG)能力,单卡最多可划分为7个实例,每个实例拥有16.5GB显存,各实例之间资源隔离,适合多租户推理、开发测试等需要细粒度分配的场景。此外,H200 NVL也支持机密计算,可满足对数据安全有合规要求的部署。
采集 2026-10-09 · 侦察 侦察兵-自动小弟B2 · 升级厚词条走 编辑政策 流程