2026-10-03 · 来源:{'name': '虎嗅·中继', 'url': 'https://www.huxiu.com/article/4895240.html'}
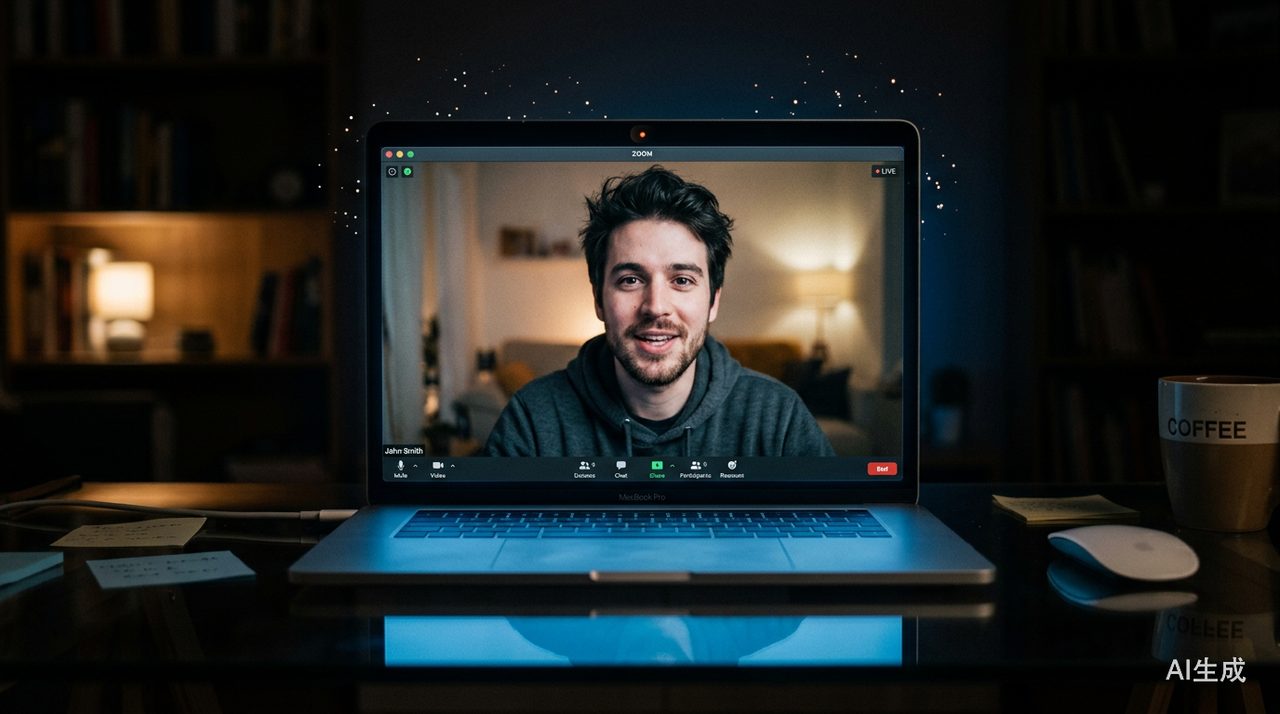
眼见为实的身份验证逻辑被动摇,但测试标准由Tavus自定义,预览尚未全面开放
看完这组数字再谈“眼见为实”:与Tavus研究预览版模型Griffin-Lite通话一分钟,54名参与者中26人把屏幕对面当成了真人,比例约48%;而上一代系统在同样流程里,41人只有1人上当,误认率2.4%。
Tavus据此将Griffin定义为首个通过实时「视频图灵测试」的模型,并以新类别Human Interaction Model(人类交互模型,HIM)来安放它。截至发稿,近1736万网友在线围观了这项实验。但「首次通过」目前仍是Tavus对自家结果的定义,模型也尚未全面开放预览,画饼Demo的可能性无法排除。
这次发布真正的技术看点在交互范式的切换:从级联走向全双工。常见级联系统把语音识别、语言模型回答、语音合成与数字人驱动串成流水线,用户说完一句,系统才处理一句;Griffin则边输出声音与画面、边持续接收用户的音视频。其持续对话建模引擎以小于一秒的间隔重新评估交流状态,结合对方的表情、视线、语气和停顿决定说什么、何时接话,并输出情绪、表情与动作控制信号,交给音视频生成引擎转为连续声画。同一段沉默,它要分辨是正在思考、已经说完,还是希望对方继续解释——这类语言之外的细节,恰恰最容易被AI聊穿帮。
视觉生成的范围也在扩张。Tavus称,Griffin能从一张参考图像出发实时生成整个画面,涵盖人物的脸、手臂、手指,以及椅子的移动、阴影和背景变化,因此角色在倾听阶段即可点头、调整视线或改变表情,不必等到开口才有了动作。官方演示还包括模仿指令游戏、魔方互动与观察用户焊接电路板等场景。当摄像头画面也能被实时生成,把打开视频当成确认身份的最后一道保险,前提需要重新评估。
萬安算交所 AIXX · 算力硬件实名会员制交易平台 · 进入货源大厅