2026-09-17 · 来源:{'name': 'KDNuggets', 'url': 'https://www.kdnuggets.com/2026/09/prnews.io/whats-actually-inside-24723-tokens-of-a-search-result-we-broke-it-down-field-by-field'}
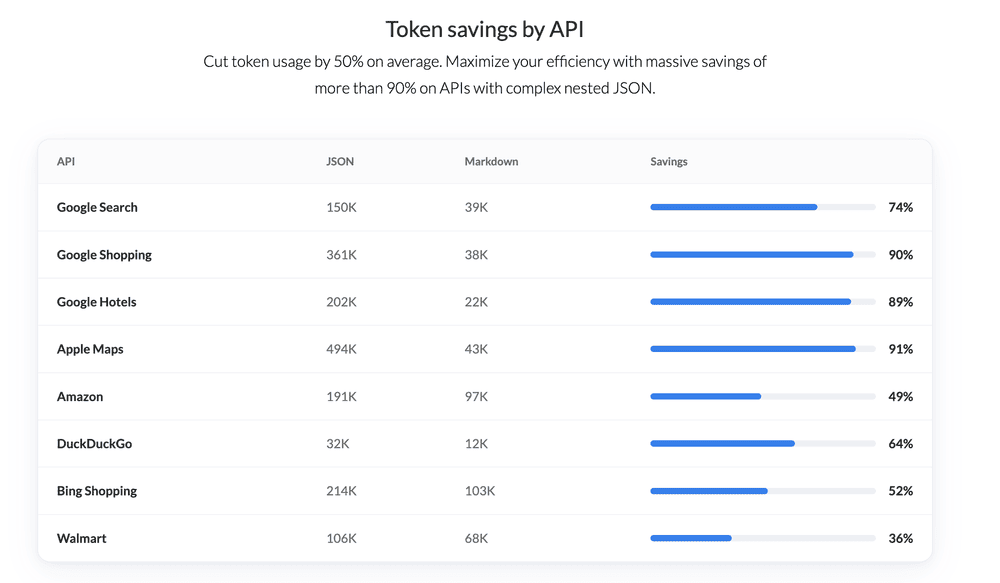
对一条24,723 Token搜索结果的逐字段拆解显示,SerpApi的Markdown输出格式可将Token消耗最多削减74%,为AI智能体省下真金白银,并缓解上下文窗口压力。
一条搜索结果在AI智能体尚未展开任何有效推理之前,就可能悄然吃掉24,723个Token——这正是KDnuggets上一篇逐字段拆解文章的出发点。该分析细致解剖了这样一个数据载荷的构成方式,并指出SerpApi的Markdown输出格式可将搜索结果的Token消耗最高削减74%。
对于运营搜索驱动智能体的团队来说,Token数量绝非抽象指标。检索结果中的每一个Token都要按输入价格计费,并挤占宝贵的上下文窗口空间——这些空间本可用于存放文档、工具输出或模型自身的推理过程。KDnuggets这篇文章对一条搜索结果进行解剖,逐字段拆解总量,展示这些开销从何而来,把'结构化但冗长'的数据载荷定位为智能体流水线上的一笔隐形税负,并在多步工作流的每一次检索环节中不断累积。
最核心的发现是,SerpApi的Markdown输出最高可带来74%的缩减。以24,723个Token为基准,如此量级的削减能把单条结果压缩至原始体积的四分之一左右,在降低单次调用成本的同时,为下游推理腾出成比例更多的上下文空间。对智能体开发者而言,这笔经济账还会迅速放大:检索密集型系统每执行一个任务就要发起多次搜索,开销随之成倍叠加——而这正是文章所称Markdown输出所化解的成本与上下文窗口负担。
采购方解读这些数字时应留意其来源:这份拆解通过prnews.io分发渠道发表于KDnuggets,因此24,723个Token的基准值和74%的削减上限都是厂商口径的数据,而非独立基准测试结果。尽管如此,这篇文章仍是有益提醒:当Token支出与上下文长度限制成为瓶颈时,输出格式——而不仅仅是模型选型或提示词设计——是采购与平台团队可以拉动的一根杠杆。
萬安算交所 AIXX · 算力硬件实名会员制交易平台 · 进入货源大厅