2026-09-10 · 来源:{'name': 'KDNuggets', 'url': 'https://www.kdnuggets.com/7-approaches-to-efficient-llm-training-on-limited-hardware'}
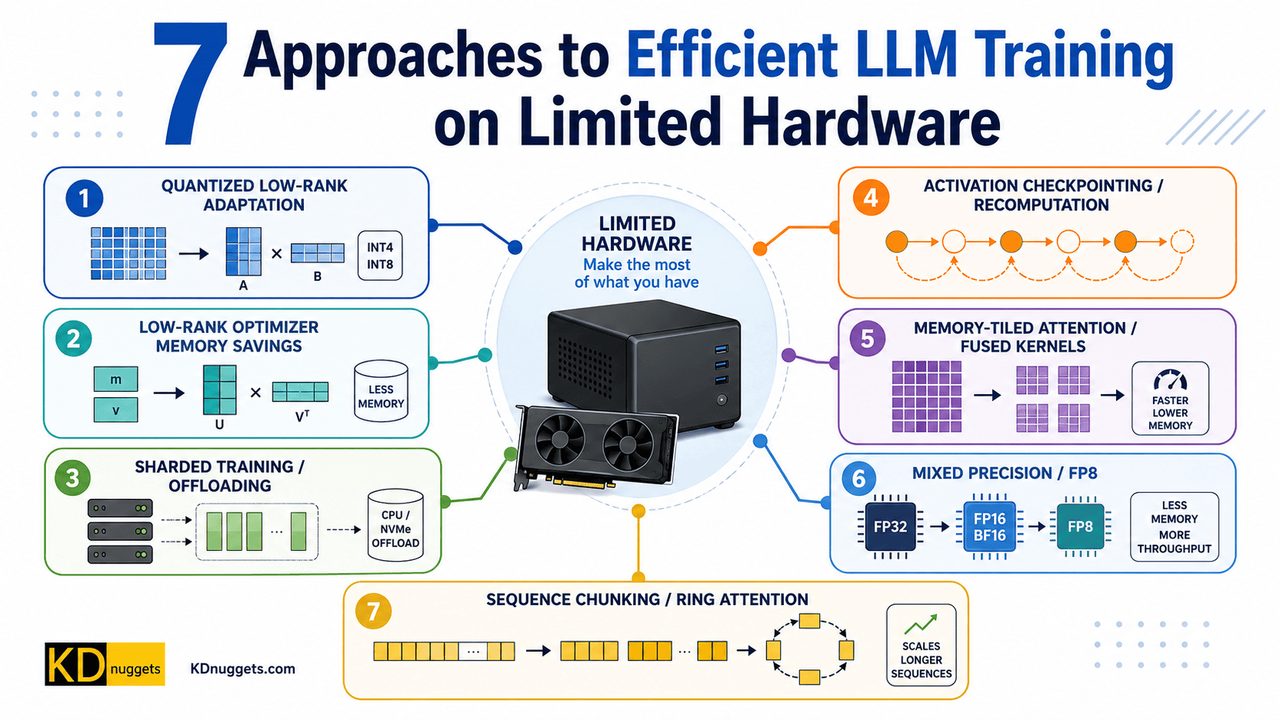
KDNuggets 发布的一篇指南详细介绍了七种工程方法,让从业者在消费级 GPU 上训练大语言模型而不至于耗尽显存。
KDNuggets 刊发了一份技术详解,介绍七种旨在让大语言模型训练在消费级 GPU 上成为可能的工程方法——在这类硬件上,显存耗尽是最大的制约。该指南面向那些需要在没有数据中心级加速器基础设施的情况下训练或微调模型的从业者,并将显存管理而非原始算力定位为亟待解决的核心问题。
这一前提至关重要,因为大语言模型训练中的显存压力毫不留情:模型参数、梯度、激活值和优化器状态必须共存于有限的显存池中,而消费级显卡的显存容量远低于数据中心加速器。一旦显存耗尽,无论理论算力多么充裕,训练都会陷入停滞。文中汇集的七种技术正是针对这一失效模式的工程应对,目标是在原本力不从心的硬件上让训练得以持续进行。
对专业读者而言,其意义不在于任何单一技术,而在于背后的趋势:效率工程已成为一门决定何种硬件能够胜任大模型训练的一等学科。
萬安算交所 AIXX · 算力硬件实名会员制交易平台 · 进入货源大厅