2026-09-16 · 来源:{'name': 'KDNuggets', 'url': 'https://www.kdnuggets.com/how-to-build-effective-evals-for-ai-agents'}
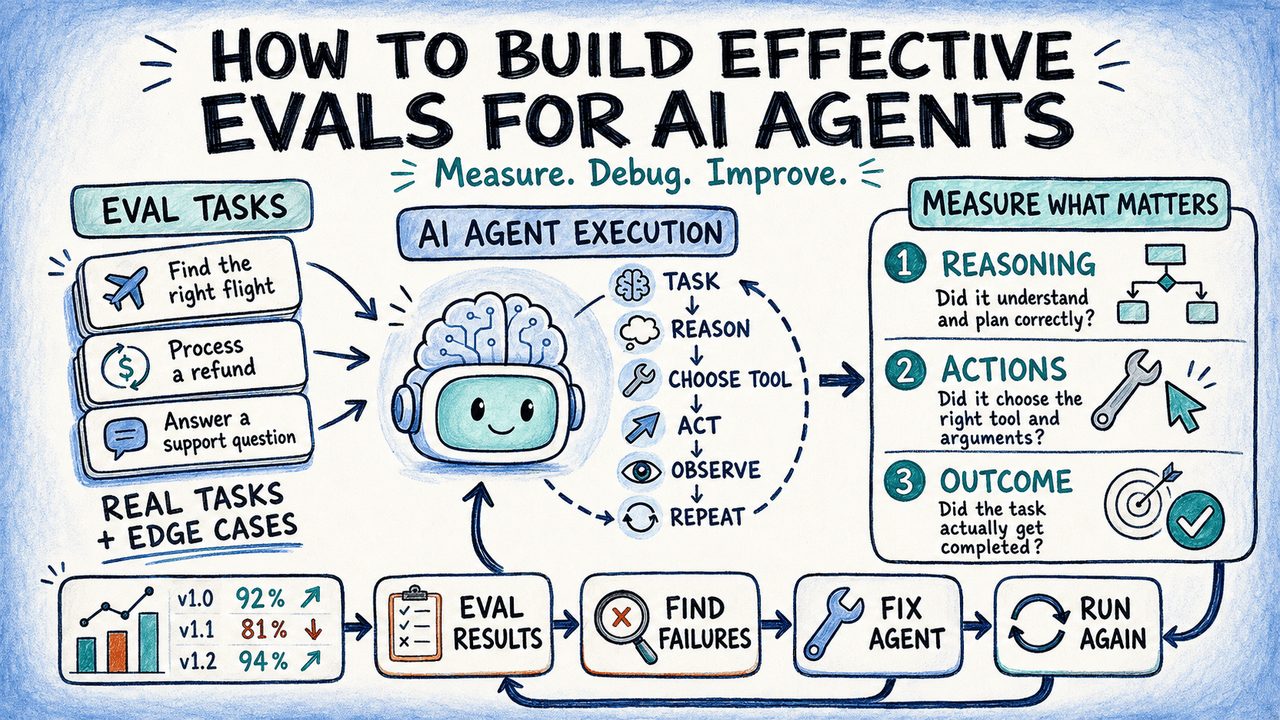
KDNuggets提出了智能体评估的四步法:设计清晰任务、选择合适评分器、构建可靠的评测框架,并持续追踪性能变化。
KDNuggets发布的一份技术指南,带领从业者一步步为AI智能体构建有效的评估(即"evals")。文章围绕四大核心要素组织这项工作:设计清晰的任务、选择合适的评分器、构建可靠的评测框架,以及追踪长期变化。这些步骤共同构成一套框架,旨在让智能体行为可被度量,而非凭印象判断。
该指南将任务设计定位为一切评估工作的基石。有效的评估始于设计清晰的任务,前提是:界定不清的任务会让评估产出的任何分数都失去意义。任务确定后,下一个决策关乎评分器——即判定输出的组件。文章强调要为具体工作选择合适的评分器,因为评分器实质上决定了一项评估测量什么、奖励什么。
在任务与评分器设计之外,原文还强调可靠评测框架(eval harness)的重要性——它是确保评估一致性运行的支撑架构。一个可靠的评测框架被视为结果可信的前提,可确保评估每次运行时执行方式保持一致。最后一个要素关乎时间维度:持续追踪变化,让团队能观察随着提示词、模型或底层系统的更新,智能体性能如何演变。
对于在生产环境中部署智能体的企业团队而言,该指南传递的深层信息是:评估应被视为工程基础设施,而非事后补做的工作。界定清晰的任务、合适的评分器、稳定的评测框架加上纵向追踪,共同提供了一条结构化路径,帮助团队弄清智能体是否按预期运行——以及任何一项改动在触及终端用户之前,究竟带来了提升还是退化。
萬安算交所 AIXX · 算力硬件实名会员制交易平台 · 进入货源大厅