2026-09-19 · 来源:{'name': 'deep-www.marktechpost.com-p10', 'url': 'https://www.marktechpost.com/2026/08/26/alibabas-qwen-team-releases-qwen3-8-flash-next-a-125b-multimodal-moe-with-6b-active-parameters-previewing-the-qwen4-architecture/'}
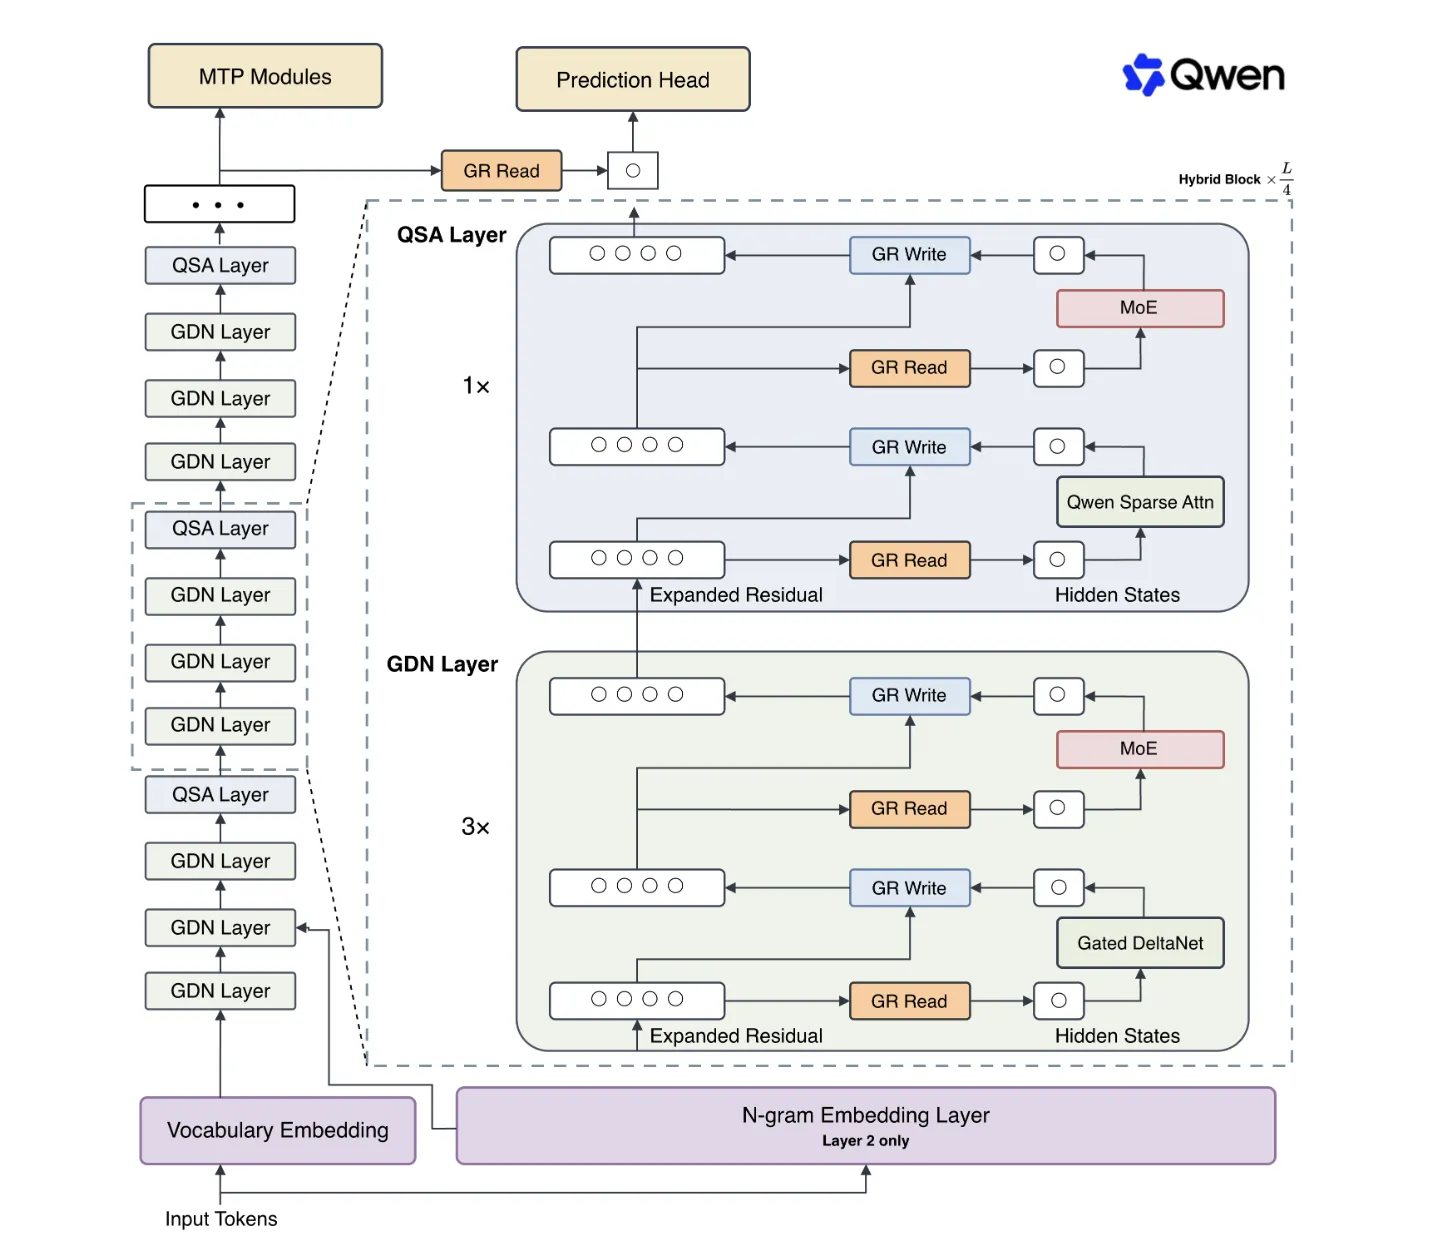
阿里Qwen团队发布开放权重多模态混合专家模型,定位为Qwen4架构早期预览:125B主干搭配N-gram嵌入与多token预测。
阿里巴巴Qwen团队发布了Qwen3.8-Flash-Next,这是一个开放权重的多模态混合专家模型,被定位为Qwen4一代所用架构的早期预览。该模型将每个token的计算集中在一个很小的激活规模内,同时保留一个大得多的稀疏参数基底,这种结构使其与总参数量相当的稠密模型明显区分开来。
其参数构成颇为少见。Qwen3.8-Flash-Next总参数量为1800亿,其中每个token仅激活60亿。其余参数分布在125B主干、510亿的N-gram嵌入表和40亿的多token预测模块中。仅嵌入表就占了全部参数的四分之一以上,使N-gram组件成为该设计最具标志性的特征之一。
四项架构变革定义了这款模型:Gated DeltaNet与Qwen Sparse Attention相结合的混合设计、Gated Residual门控残差机制、N-gram嵌入,以及Muon优化器。这些组件共同构成了Qwen4架构预览的核心内容,为开发者和基础设施规划者提供了一个可早期运行的参考点,借以把握阿里模型技术栈的演进方向。
在效率方面,最引人注目的说法是其训练成本据称为Qwen3.7-Plus的九分之一。这一对比直指大规模训练或微调机构最关心的经济性问题,随模型一同发布的基准测试结果也将被放到这把标尺下解读。
萬安算交所 AIXX · 算力硬件实名会员制交易平台 · 进入货源大厅